Muestreo adaptativo con multiplexación (MAS_9238_v114_revA_11Nov2026)


PromethION: Protocol
Muestreo adaptativo con multiplexación V MAS_9238_v114_revA_11Nov2026
Este protocolo explica la preparación de bibliotecas y la secuenciación con muestreo adaptativo de ADN genómico humano, desde la extracción hasta los archivos BAM con las bases identificadas y separados por códigos de barras.
El protocolo:
- Utiliza ADN genómico de alto peso molecular extraído de sangre humana.
- Agrupa exactamente tres muestras con código de barras en cada celda de flujo PromethION.
- Está destinado principalmente a aplicaciones de línea germinal.
- Enriquece las regiones de interés definidas en un archivo BED, que se exporta desde la herramienta Digital Panel Designer si se usa un panel personalizado o se descarga si se usa un panel prediseñado.
- No requiere PCR, por lo que se conserva la metilación sin amplificación.
- Es compatible con celdas de flujo R10.4.1 en PromethION 24 y PromethION 2 Integrated
De uso exclusivo en investigación
FOR RESEARCH USE ONLY.
Contents
Introducción al protocolo
- 1. Descripción general del protocolo
- 2. Aprovechar los paneles digitales listos para usar
- 3. Descripción general de los pasos del flujo de trabajo
- 4. Antes de empezar
- 5. Material y consumibles
Preparación de muestras
- 6. Orientaciones sobre el protocolo de extracción de ADN recomendado
- 7. Fragmentación de ADN con un tubo g-TUBE
Preparación de la biblioteca
- 8. Reparación del ADN y preparación de los extremos
- 9. Ligación directa de códigos de barras
- 10. Ligación de los adaptadores y purificación
- 11. Acondicionamiento y carga de celdas de flujo PromethION
Secuenciación y análisis de datos
- 12. Adquisición de datos e identificación de bases
- 13. Datos de salida y análisis
- 14. Reutilización y devolución de celdas de flujo
Resolución de problemas
Descripción general
Este protocolo explica la preparación de bibliotecas y la secuenciación con muestreo adaptativo de ADN genómico humano, desde la extracción hasta los archivos BAM con las bases identificadas y separados por códigos de barras.
El protocolo:
- Utiliza ADN genómico de alto peso molecular extraído de sangre humana.
- Agrupa exactamente tres muestras con código de barras en cada celda de flujo PromethION.
- Está destinado principalmente a aplicaciones de línea germinal.
- Enriquece las regiones de interés definidas en un archivo BED, que se exporta desde la herramienta Digital Panel Designer si se usa un panel personalizado o se descarga si se usa un panel prediseñado.
- No requiere PCR, por lo que se conserva la metilación sin amplificación.
- Es compatible con celdas de flujo R10.4.1 en PromethION 24 y PromethION 2 Integrated
De uso exclusivo en investigación
1. Descripción general del protocolo
Introducción
Este protocolo explica la preparación de la biblioteca y la secuenciación mediante muestreo adaptativo de tres muestras por celda de flujo PromethION, que emplea el kit Native Barcoding y la función de enriquecimiento de secuencias objetivo mediante muestreo adaptativo de MinKNOW. Los paquetes de Muestreo adaptativo con multiplexación suministrados por Oxford Nanopore Technologies (links from Simon), que se fabrican en formato de 18 o 72 muestras, incluyen todos los reactivos necesarios en este protocolo. Los paquetes incluyen el kit Native Barcoding y los elementos necesarios en la secuenciación y constituyen la configuración habitual en este flujo de trabajo.
Es posible utilizar un panel digital listo para usar y de uso exclusivo en investigación de Oxford Nanopore como panel definido por el archivo BED o bien crear un panel digital personalizado con la herramienta de diseño de paneles digitales de muestreo adaptativo. Si desea crear un panel a medida, consulte la Guía técnica de muestreo adaptativo: Herramienta de diseño de paneles digitales.
El análisis de los datos no forma parte de este protocolo. La sección Datos generados y análisis (sección 13) explica qué archivo BED exportado utilizar y el flujo de trabajo correspondiente a cada panel: wf-hereditary-cancer para el Panel de cáncer hereditario y wf-human-variation para los paneles personalizados de línea germinal.
Uso previsto y rendimiento esperado
El protocolo Muestreo adaptativo con multiplexación está pensando sobre todo para aplicaciones de línea germinal, en las que cada muestra necesita una cobertura moderada en todo el panel, en lugar de la profundidad necesaria para detectar variantes de baja frecuencia.
En paneles que abarcan entre el 0,1 % y el 5 % del genoma, se espera que cada una de las tres muestras de la celda de flujo alcance una cobertura media de 30x en las regiones objetivo y que alrededor del 90 % de las bases de estas regiones quede cubierto con una profundidad de superior a 20x. Los paneles personalizados difieren de tamaño, contenido génico y contexto de secuencia, por lo que es posible que la cobertura que su panel sea distinta. La cobertura también depende del número de poros utilizables de la celda de flujo, la longitud de fragmentos de la biblioteca y el equilibrio con que las tres muestras estén representadas en el conjunto.
Recomendamos realizar un ensayo preliminar con su panel y comprobar la cobertura que necesita antes de procesar un gran número de muestras.
2. Aprovechar los paneles digitales listos para usar
Oxford Nanopore digital panel specification
Ready-to-use digital panels:
| Hereditary Cancer | Pan-Caner | Pan-Haematological Cancer | |
|---|---|---|---|
| Enriched genes | 258 inherited cancer risk genes | 723 cancer associated genes | 144 haematological malignancies associated genes |
| Validated Adaptive Sampling protocols | Multiplex Adaptive Sampling | Ultra-rapid singleplex Adaptive Sampling Singleplex Adaptive Sampling | Singleplex Adaptive Sampling |
| Input amount† | 1 µg | Ultra-rapid singleplex: 1 µg Singleplex: 500 ng to 1 µg* | 1 µg |
| Input sample type | Blood | Solid tumour tissue | Blood Bone marrow |
| Recommended extraction kits | Genomic DNA extraction from human blood using the Qiagen Puregene kit‡ | 1. QIAamp Fast DNA Tissue Kit (Qiagen, 51404) Recommended for Ultra-rapid singleplex Adaptive Sampling 2. Puregene Tissue Kit (Qiagen, 158063) 3. MagAttract HMW DNA Kit (Qiagen, 67563) | 1. Genomic DNA extraction from human blood using the Qiagen Puregene kit‡ 2. QIAamp DSP DNA Mini Kit (Qiagen, 61304) 3. GenFind V3 Genomic DNA Extraction Kit (Beckman Coulter, C34880) |
| QC info (Femto Pulse) | Extracted gDNA samples may be assessed on the Femto Pulse System to visualise the unsheared/sheared gDNA profiles. For example profiles refer to the Input DNA section. | Extracted gDNA samples may be assessed on the Femto Pulse System to visualise the unsheared/sheared gDNA profiles. For example profiles refer to the DNA QC section. For the Ultra-rapid singleplex AS protocol, perform gDNA quality control assessment after completion of the sequencing run using aliquots reserved during the relevant sample preparation steps. | Extracted gDNA samples may be assessed on the Femto Pulse System to visualise the unsheared/sheared gDNA profiles. For example profiles refer to the DNA QC section. |
| Shearing conditions (speed and time) | Three centrifugation steps at ~3,381 RCF for 1 minute each. Refer to the corresponding protocol step for further details. | Two centrifugation steps at ~3,381 RCF for 30 seconds each. Refer to the corresponding protocol step for further details. | Two centrifugation steps at ~4,868 RCF for 1 minute each. Refer to the corresponding protocol step for further details. |
| Reference genomes | GRCh38_GIABv3 | GRCh38_GIABv3 | GCA_000001405.15_GRCh38_no_alt_analysis_set.fna |
| Enrichment BED file (links to the BED files can be found on the Adaptive Sampling page) | ONT_AS_HCP_GRCh38_enrichment_v1.bed | ONT_AS_PanCancer_GRCh38_enrichment_v1.bed | ONT_AS_PanHaem_GRCh38_enrichment_v1.bed |
*A lower input limit of 500 ng can be used; however 1 µg is recommended whenever possible to improve pore occupancy.
†A maximum of 2 µg input can be used to maximise pore occupancy.
‡This Oxford Nanopore adapted extraction method uses the Puregene Blood Kit (Qiagen, 158023). It has gentler mixing conditions and resuspends the final DNA at 50°C rather than 65°C.
3. Descripción general de los pasos del flujo de trabajo
Preparación del experimento
Pasos:
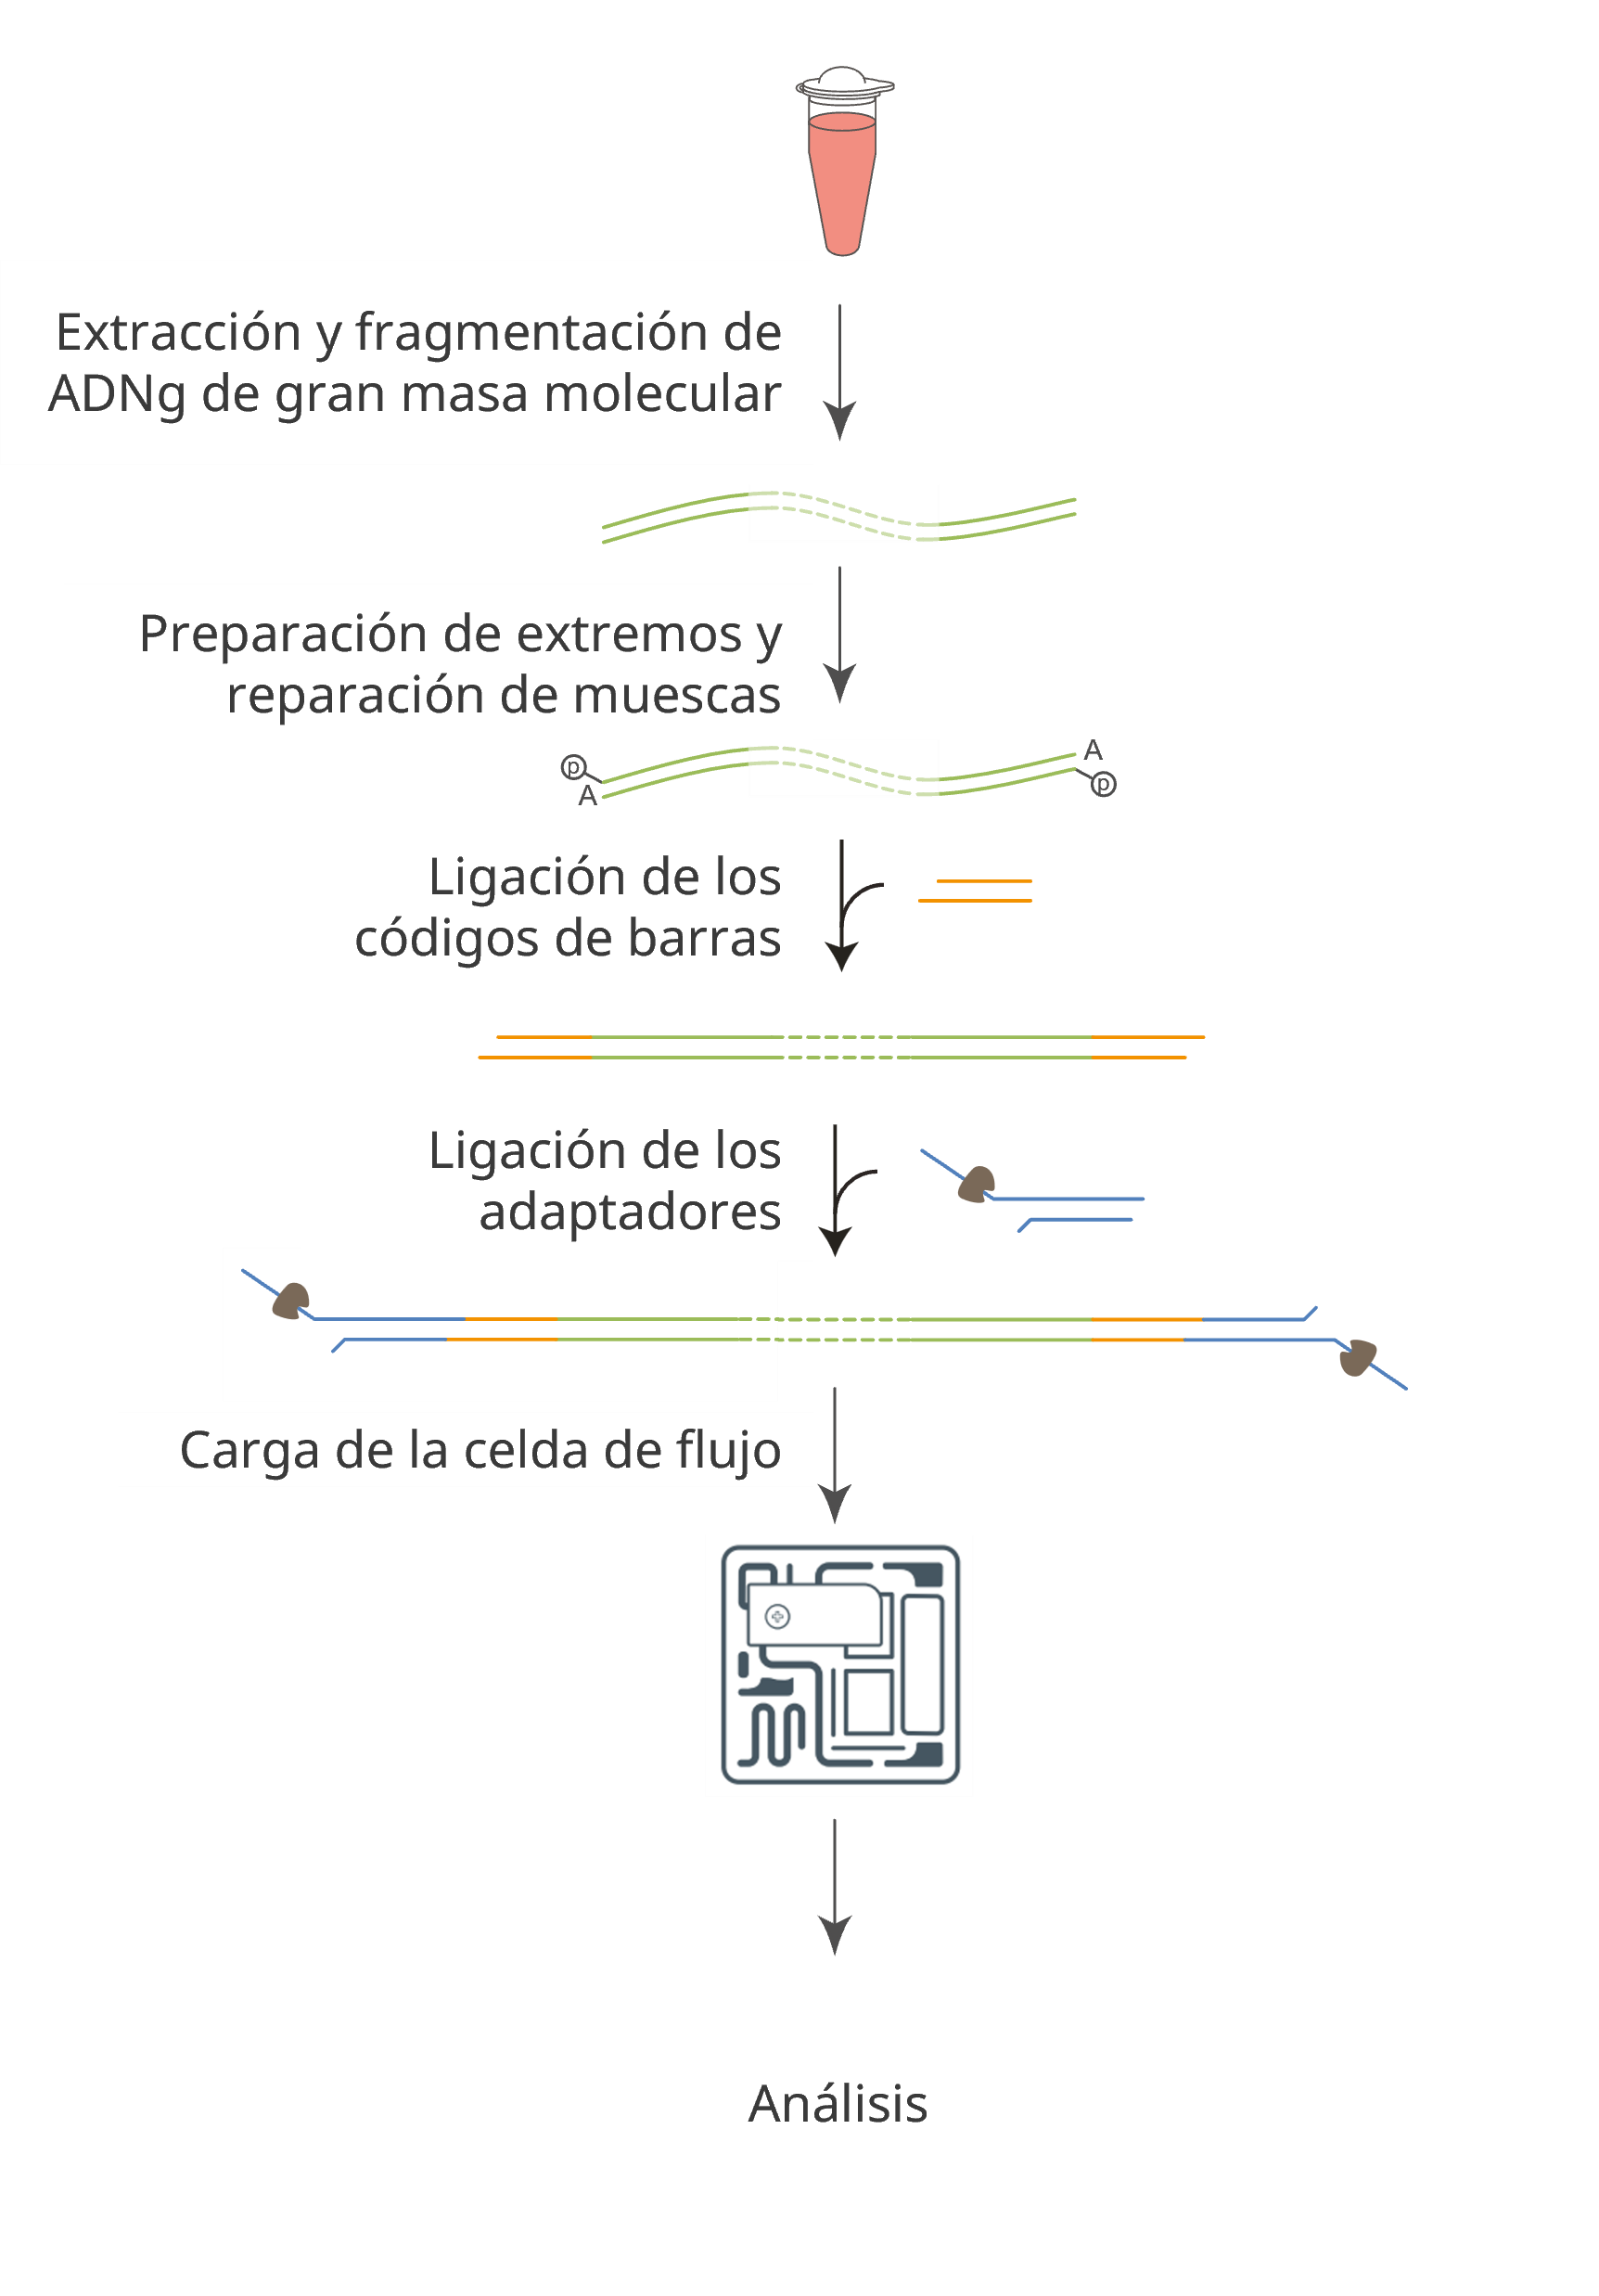
- Extraer ADNg de gran masa molecular de cada muestra de sangre, siguiendo el protocolo Extracción de ADN genómico a partir de sangre humana con el kit Puregene de Qiagen.
- Diseñar un panel personalizado en Digital Panel Designer y exportar los archivos BED o descargar los archivos BED de un panel prediseñado y el archivo FASTA de referencia correspondiente (apartado 4).
- Tener a disposición el kit de secuenciación, el instrumental pertinente y los reactivos de otros fabricantes.
- Verificar la celda de flujo y comprobar que tiene poros suficientes para realizar una buena secuenciación.
Preparación de muestras, preparación de bibliotecas y secuenciación
| Etapa | Proceso | Duración | Parada opcional |
|---|---|---|---|
| Preparación de muestras | Extraer el ADN genómico de la muestra, fragmentarlo y cuantificarlo. Comprobar la longitud, cantidad y pureza del material extraído. Los controles de calidad realizados durante el protocolo son esenciales para garantizar el éxito del experimento. | Depende del método de extracción utilizado 15 minutos aproximadamente en la fragmentación | En esta etapa, es posible guardar el ADN extraído o fragmentado a –20 °C y utilizarlo más adelante. |
| Reparación del ADN y preparación de los extremos | Reparar el ADNg y preparar los extremos para la ligación de adaptadores. | 60 minutos | 4 °C durante la noche |
| Ligación directa de códigos de barras | Ligar los códigos de barras (sin PCR) a los extremos del ADN. | 70 minutos | 4 °C durante la noche |
| Ligación de adaptadores de secuenciación y purificación | Ligar los adaptadores a los extremos de ADN. | 60 minutos | a 4 °C durante la noche |
| Acondicionar y cargar la celda de flujo | Acondicionar la celda de flujo y cargar la biblioteca de ADN en ella. | 10 minutos | |
| Secuenciación | Secuenciar la biblioteca con el dispositivo de secuenciación. | 72 horas | |
| Análisis de datos | Análisis con uno de los flujos de trabajo de EPI2ME |
Compatibilidad del protocolo
Este protocolo debería usarse solo junto con los siguientes productos:
- Paquete Muestreo adaptativo con multiplexación (MAS18 o MAS72))
- Kit Native Barcoding 24 V14 (SQK-NBD114.24)
- Celdas de flujo PromethION (FLO-PRO114M)
- PromethION 24 - Ficha técnica y requisitos informáticos
- PromethION 2 Integrated - Ficha técnica y requisitos informáticos
4. Antes de empezar
Archivos BED del panel
Una secuenciación con muestreo adaptativo solo se lleva a cabo correctamente si MinKNOW dispone de dos archivos: un archivo BED enriquecido, que enumera las regiones que se desea enriquecer y un archivo FASTA de referencia de la misma versión del genoma. Los archivos BED enriquecidos se crean en la herramienta de diseño de paneles Digital Panel Designer o se empieza con uno de nuestros paneles predefinidos. Las instrucciones de la herramienta de diseño de paneles, incluidas las comprobaciones de diseño y los ajustes de margen, están en la Guía técnica de muestreo adaptativo.
La exportación genera tres archivos BED y un informe de resumen. Los archivos se nombran con fecha y nombre del panel de la siguiente manera: YYYY-MM-DD_panel-name_enrichment.bed
Solo se carga en MinKNOW el archivo BED de enriquecimiento.
| Archivo | Contenido | Se utiliza en | | --- | --- | --- | | *_enrichment.bed | Dos filas por región objetivo, una de la hebra positiva y otra de la negativa, cada una con margen en el extremo 5′. | MinKNOW, en el campo BED de Muestreo adaptativo (sección 12). | | *_analysis.bed | Una fila por región objetivo, sin margen. | Cobertura e identificación de variantes en las regiones objetivo (sección 13). | | *_exons.bed | Una fila por exón en el transcrito MANE Select de cada gen o, si no existe, del transcrito canónico de Ensembl. | Análisis de cobertura por exón (sección 13). | | summary.html | Datos estadísticos del panel, comprobaciones del diseño, tabla de regiones objetivo y vista de las regiones objetivo y los márgenes de un navegador genómico. | Registro del diseño del panel. |
Genoma de referencia
MinKNOW necesita archivo de referencia FASTA con el que alinear las lecturas y tomar las decisiones de muestreo adaptativo. La referencia debe ser la misma versión del genoma que se seleccionó en la herramienta Digital Panel Designer cuando se exportó el panel. Recomendamos los siguientes archivos:
| Panel | Versión | Archivo de referencia FASTA (MinKNOW) | Origen |
|---|---|---|---|
| Panel personalizado | GRCh38 | GCA_ 000001405. 15_ GRCh38_ no_ alt_ analysis_ set. fna. gz | NCBI |
| Panel personalizado | GRCh37 | hg19. fa. gz | UCSC |
| Panel de cáncer hereditario | GRCh38 | GRCh38_ GIABv3_ no_ alt_ analysis_ set_ maskedGRC_ decoys_ MAP2K3_ KMT2C_ KCNJ18. fasta. gz | Genome in a Bottle |
Los nombres de los cromosomas del archivo de referencia FASTA deben coincidir con el archivo BED.
Los archivos BED exportados de la herramienta de diseño de paneles Digital Panel Designer utilizan nombres de cromosomas de tipo UCSC (chr1, chr2, chrX), y los tres archivos de referencia recomendados tienen los mismos nombres.
Si utiliza un archivo de referencia distinto en el que los nombres de los cromosomas no lleven el prefijo "chr" (1, 2, X), MinKNOW no encontrará ninguna de las regiones objetivo. La secuenciación continuará sin enriquecimiento y parecerá una secuenciación del genoma completo a poca profundidad.
En el caso del Panel de cáncer hereditario, recomendamos la referencia Genome in a Bottle (GIAB) v3 GRCh38, con la que se determinó el rendimiento del panel. Es el conjunto de análisis GRCh38 no-alt en el que se han enmascarado las regiones del ensamblaje duplicadas por error; por ello, utiliza las mismas coordenadas y los archivos BED del panel exportados desde Digital Panel Designer son compatibles con ella sin necesidad de modificarlos.
Los archivos GRCh38 anteriores no contienen cóntigos de loci alternativos. Si en su lugar se utiliza una referencia que los incluya, las lecturas de regiones con haplotipos alternativos, como los genes HLA, se reparten entre el ensamblaje primario y los cóntigos alternativos. El archivo hg19 contiene unos pocos cóntigos de haplotipos en la región MHC y la misma situación afecta a los paneles con regiones objetivo en esa región.
Si utiliza otro archivo de referencia con nombres de cromosomas distintos de los figuran en los archivos BED, cambie los nombres de los cromosomas en los archivos BED por los de la referencia. No cambie los nombres de los cromosomas de la referencia. No recomendamos indizar la referencia antes de cargarla, ya que MinKNOW la indiza de manera automática al inicio de la secuenciación. Los requisitos de la referencia se describen con detalle en la Guía técnica de muestreo adaptativo.
5. Material y consumibles
Material
- (PREPARACIÓN DE LA BIBLIOTECA) ~1 µg de ADNg fragmentado
- Paquetes de muestreo adaptativo con multiplexación (contienen los materiales que se indican a continuación)
- Kit Native Barcoding 24 V14 (SQK-NBD114.24)
- Material complementario LFB Expansion (EXP-LFB001)
- Material complementario SFB Expansion (EXP-SFB001), incluido en el paquete de 72 muestras
Consumibles
- Celdas de flujo PromethION (FLO-PRO114M)
- Tubo g-TUBE™ (Covaris, 520079)
- NEBNext FFPE Repair Mix (NEB M6630)
- NEBNext Ultra II End Repair/dA-tailing Module (NEB E7546)
- Mezcla maestra de ligasa NEB Blunt/TA (NEB, M0367)
- Módulo NEBNext® Quick Ligation (NEB, E6056)
- Agua sin nucleasas (p.ej. Thermo Scientific, AM9937)
- Etanol al 80 % recién preparado con agua sin nucleasas
- Kit Qubit dsDNA BR (Invitrogen, Q32850)
- Kit de ensayo Qubit™ dsDNA HS (Invitrogen, Q32851)
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
- Tubos Eppendorf DNA LoBind de 1,5 ml
- Tubos de PCR de pared fina, 0,2 ml
- Kit de análisis de ADN genómico de 165 kb (Agilent, FP-1002-0275) (opcional)
Instrumental
- Dispositivo PromethION
- Pantalla protectora celdas de flujo PromethION
- Mezclador rotatorio (tipo Hula mixer)
- Gradilla magnética, apta para tubos Eppendorf de 1,5 ml
- Microcentrífuga
- Mezclador vórtex
- Termociclador con tapa térmica
- Bloque térmico
- Puntas de pipeta de punta ancha
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P100
- Pipeta y puntas P20
- Pipeta y puntas P10
- Pipeta y puntas P2
- Pipeta multicanal y puntas
- Cubeta con hielo
- Temporizador
- Fluorímetro Qubit™ (o equivalente)
Equipo opcional
- Sistema Femto Pulse (Agilent Technologies) o equivalente
Paquetes de muestreo adaptativo con multiplexación de Oxford Nanopore Technologies
Los reactivos de Oxford Nanopore Technologies necesarios en este protocolo están incluidos en los paquetes de Muestreo adaptativo con multiplexación, de venta en la tienda Nanopore en formato de 18 o 72 muestras.
Esos paquetes incluyen el kit Native Barcoding junto con el resto de elementos de secuenciación que constituyen la configuración de referencia en este flujo de trabajo.
Si desea más información sobre elementos concretos del kit incluidos en los paquetes, consulte los productos correspondientes en la tienda Nanopore:
- Paquete Muestreo adaptativo con multiplexación 18 (18 muestras)
- Paquete Muestreo adaptativo con multiplexación 72 (72 muestras)
La lista anterior de materiales, consumibles y equipo se necesesita en la fragmentación de muestras de ADN y preparación de la biblioteca.
Los consumibles, el material y las instrucciones de extracción de ADN recomendadas se encuentran en el protocolo Extracción de ADN genómico a partir de sangre humana con el kit Puregene de Qiagen.
En este protocolo, en la preparación de la biblioteca se necesita el siguiente material de partida:
- ~1 µg de ADNg fragmentado
ADN de partida
Hemos homologado este protocolo con ADNg extraído de sangre humana fresca, recogida en tubos con EDTA K2. La extracción se realizó con el kit Puregene Blood (Qiagen, 158023), a partir de 1 ml de sangre y con un método adaptado de Oxford Nanopore, que mezcla con más suavidad y resuspende el ADN final a 50 °C en lugar de a 65 °C. El método está detallado en el protocolo Extracción de ADN genómico a partir de sangre humana con el kit Puregene de Qiagen.
No hemos probado otros kits de extracción con este protocolo. Es posible que el ADNg de sangre extraído con otro kit ofrezca un buen rendimiento si cumple los requisitos siguientes, pero cumplirlos no es una garantía, ya que el perfil de longitud de fragmentos y de pureza del ADN influye en el enriquecimiento y en la cantidad de datos generados. Si utiliza otro kit, recomendamos realizar un experimento preliminar y comprobar que se obtiene la cobertura necesaria antes de procesar un gran número de muestras.
| Requisito | Valor | Cómo comprobarlo |
|---|---|---|
| Cantidad | Más de 1 µg por muestra, con una concentración de al menos 20 ng/µl, de modo que 1 µg quepa en los 50 µl que admite el tubo g-TUBE (Covaris) | Qubit dsDNA BR Assay, por triplicado |
| Pureza | DO 260/280 ≥ 1,8 y DO 260/230 de 2,0 a 2,2 | NanoDrop o equivalente |
| Longitud de los fragmentos | ADNg de alto peso molecular (HMW) En la figura 1 se muestra una extracción típica con Puregene. | Femto Pulse o equivalente (opcional) |
 Figura 1. Ejemplo de perfil de longitudes de fragmentos de ADNg extraído de sangre humana con el método Puregene adaptado.
El tubo g-TUBE fragmenta ADN hasta una longitud objetivo, pero no lo alarga. El ADNg que tras la extracción es más corto de lo previsto, lo seguirá siendo tras la fragmentación y como resultado, la longitud de lectura será menor.
Realizar el control de calidad
Es importante que el ADN de partida cumpla con los requisitos de cantidad y calidad. Usar demasiado ADN, poco o de mala calidad (p. ej., que esté muy fragmentado, que contenga ARN o contaminantes químicos), afecta a la preparación de la biblioteca.
Siga las instrucciones sobre cómo realizar un control de calidad de la muestra de ADN, en el protocolo Input DNA/ RNA QC.
Contaminantes químicos
Según cómo se extraiga el ADN de la muestra original, ciertos contaminantes químicos quedan en el ADN purificado y afectan tanto a la eficacia de la preparación de la biblioteca como a la calidad de la secuenciación. Encontrará más información sobre contaminantes en la página Contaminants de la comunidad Nanopore.
Orientación de los tubos Eppendorf en la centrífuga
En los pasos de centrifugación, colocar los tubos con la bisagra orientada hacia la pared de la centrífuga ayudará en la identificación visual del sedimento.
Manipular los tubos con cuidado al retirarlos de la centrífuga a fin de evitar desestabilizar el sedimento.

Reactivos de otros fabricantes
Hemos probado y recomendamos el uso de todos los reactivos de otros fabricantes usados en este protocolo. Oxford Nanopore Technologies no ha evaluado otras alternativas.
A menos que se especifique en el protocolo, recomendamos preparar estos reactivos siguiendo las instrucciones del fabricante.
Comprobación de la celda de flujo
Antes de iniciar un experimento de secuenciación y dentro del plazo de garantía, recomendamos encarecidamente comprobar el número de poros presente en la celda de flujo. Las celdas de flujo deben sacarse de la nevera y de su envoltorio y se debe esperar 30 minutos a que se pongan a temperatura ambiente.
Siga las instrucciones del documento Comprobación de celdas de flujo; al realizar la comprobación, verá el número de poros que tiene. La garantía cubre un mínimo de 5 000 poros en celdas PromethION. Encontrará más información sobre el plazo de garantía, la estabilidad y las condiciones de almacenamiento en la tienda de Oxford Nanopore. Si tiene alguna duda o pregunta, contacte con Oxford Nanopore.
Oxford Nanopore Technologies sustituirá cualquier celda de flujo PromethION con menos de 5 000 poros, siempre y cuando el resultado se notifique dentro de los dos días siguientes a la comprobación y se hayan seguido las instrucciones de almacenamiento.
El reactivo Native Adapter (NA) utilizado en este protocolo no es intercambiable con otros adaptadores de secuenciación.
6. Orientaciones sobre el protocolo de extracción de ADN recomendado
Prepare la(s) muestra(s) que se someterán a la extracción:
A continuación incluimos un protocolo recomendado de extracción de ADN genómico a partir de sangre:
Extracción de ADN genómico a partir de sangre humana mediante el kit Puregene de Qiagen
Finalizada la extracción de ADN, proceder con la fragmentación de ADN. Como alternativa, es posible guardar la(s) muestra(s) a 4 °C hasta el día siguiente.
7. Fragmentación de ADN con un tubo g-TUBE
Material
- >1 µg de ADNg extraído por muestra
Consumibles
- Tubo g-TUBE (Covaris, 520079)
- Agua sin nucleasas (p. ej., Thermo Fisher AM9937)
- Kit Qubit dsDNA BR (Invitrogen, Q32850)
- Tubos Qubit™ Assay (Thermo Fisher, Q32856)
- Tubos Eppendorf DNA LoBind de 1,5 ml
- Kit de análisis de ADN genómico de 165 kb (Agilent, FP-1002-0275) (opcional)
Instrumental
- Centrifuga Eppendorf 5424 (o equivalente)
- Microcentrífuga
- Fluorímetro Qubit™ (o equivalente)
- Cubeta con hielo
- Temporizador
- Puntas de pipeta de punta ancha
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P100
- Pipeta y puntas P20
- Pipeta y puntas P10
- Pipeta y puntas P2
Equipo opcional
- Sistema Femto Pulse (Agilent Technologies) o equivalente
Preparar el ADN en agua sin nucleasas:
1. Comprobar que dispone de 1 μg de ADNg extraído de la muestra y transferir a un tubo Eppendorf de 1,5 ml.
2. Ajustar el volumen a un total de 50 μl con agua sin nucleasas.
3. Mezclar minuciosamente aspirando y expulsando con una pipeta de punta ancha.
4. Centrifugar brevemente en la microcentrífuga.
Transferir 50 μl de la muestra a la parte superior del tubo g-TUBE y enroscar el tapón con firmeza.
Cargar el tubo de la muestra en la centrífuga y comprobar que el instrumento esté correctamente equilibrado de acuerdo con las instrucciones del fabricante.
Centrifugar la muestra de la siguiente forma:
Nota: las velocidades suelen variar según el tipo de centrífuga que se utilice. Consulte esta información en el manual del fabricante del dispositivo que utilice.
1. Centrífugar a 3 381 × g (6 000 rpm) durante 60 segundos.
2. Comprobar que la muestra haya pasado por completo de la cámara superior a la cámara inferior del tubo g-TUBE. Si no ha pasado, repetir la operación hasta que pase por completo a la cámara inferior.
3. Retirar el tubo g-TUBE de la centrífuga, invertirlo y colocarlo de nuevo, asegurándose de que la muestra esté en la cámara superior del tubo.
4. Centrifugar el tubo de nuevo a la misma velocidad y durante el mismo tiempo que en el paso anterior: 3 381 × g (6 000 rpm) durante 60 segundos.
5. Comprobar que la muestra haya pasado por completo de la cámara superior a la cámara inferior del tubo g-TUBE. Si no ha pasado, repetir la operación hasta que pase por completo a la cámara inferior.
Repetir el paso anterior dos veces más hasta pasar la muestra a través del tubo g-TUBE un total de 3 veces en cada dirección.
Cuando la muestra esté en la cámara inferior, desenroscar el cuerpo del tubo y conservar el tapón de rosca que contiene la muestra.
Recuperar la muestra del tapón y transferirla a un tubo Eppendorf de 1,5 ml.
Cuantificar la muestra mediante el kit Qubit dsDNA BR Assay.
Nota: tras la fragmentación, se espera recuperar 1 µg de ADNg aproximadamente. Se estima que las lecturas de Qubit deben situarse entre 18 y 20 ng/μl aproximadamente.
El ADNg fragmentado también se analiza mediante el Femto Pulse de Agilent para determinar el tamaño de sus fragmentos.
La longitud prevista de los fragmentos es de entre 7,5 y 8,5 kb aproximadamente.
Tomar los 48 µl de ADNg fragmentado y proseguir con la preparación de la biblioteca. Otra alternativa es guardar la muestra a 4 °C durante la noche.
8. Reparación del ADN y preparación de los extremos
Material
- 1 µg de ADNg fragmentado en 48 µl por muestra
Consumibles
- Mezcla de reparación de ADN NEBNext® FFPE DNA Repair Mix (NEB, M6630)
- Módulo NEBNext® Ultra™ II End Repair/dA-Tailing (NEB, E7546)
- Agua sin nucleasas (p.ej. Thermo Scientific, AM9937)
- Etanol al 80 % recién preparado con agua sin nucleasas
- Kit de ensayo Qubit™ dsDNA BR (Invitrogen, Q32850)
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
- Tubos de PCR de pared fina, 0,2 ml
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Microcentrífuga
- Mezclador vórtex
- Termociclador con tapa térmica
- Mezclador rotatorio (tipo Hula mixer)
- Gradilla de separación magnética, compatible con tubos Eppendorf de 1,5 ml
- Fluorímetro Qubit (o equivalente para el CC)
- Cubeta con hielo
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P100
- Pipeta y puntas P20
- Pipeta y puntas P10
- Pipeta y puntas P2
Preparar los reactivos NEBNext FFPE DNA Repair Mix y NEBNext Ultra II End Repair/dA-tailing Module siguiendo las instrucciones del fabricante y poner en hielo.
A fin de obtener un rendimiento óptimo, NEB recomienda lo siguiente:
Descongelar todos los reactivos en hielo.
Golpear suavemente los tubos de los reactivos con el índice o invertirlos hasta que estén bien mezclados.
Importante: no mezclar en vórtex las mezclas FFPE DNA Repair Mix o Ultra II End Prep Enzyme Mix.Centrifugar brevemente los tubos antes de abrirlos.
Los amortiguadores Ultra II End Prep Reaction Buffer y FFPE DNA Repair Buffer tal vez tengan un precipitado. Dejar que alcancen la temperatura ambiente y mezclar con la pipeta varias veces hasta homogeneizar el precipitado; agitar mediante vórtex durante 30 segundos hasta solubilizarlo.
Nota: es importante mezclar bien los amortiguadores mediante vórtex.El amortiguador FFPE DNA Repair Buffer tal vez tenga un matiz amarillo.
No mezclar en vórtex las mezclas NEBNext FFPE DNA Repair Mix o NEBNext Ultra II End Prep Enzyme Mix.
Es importante mezclar bien mediante vortex los amortiguadores NEBNext FFPE DNA Repair Buffer y NEBNext Ultra II End Prep Reaction Buffer.
Examinar que no haya precipitados visibles; en ocasiones es necesario mezclar en vortex al menos durante 30 segundos hasta solubilizarlos.
Preparar la(s) muestra(s) de ADN.
1. Por cada muestra, disponer de 48 µl (con 1 µg de muestra) en un tubo de PCR de pared fina (0,2 ml).
2. Mezclar cada muestra minuciosamente con la pipeta o dar suaves golpecitos al tubo con el índice. Centrifugar brevemente en la microcentrífuga.
Agregar los siguientes elementos a cada tubo:
| Reactivo | Volumen |
|---|---|
| Muestra de ADN | 48 µl |
| Ultra II End-prep Reaction Buffer | 3,5 µl |
| Ultra II End-prep Enzyme Mix | 3 µl |
| NEBNext FFPE DNA Repair Buffer | 3,5 µl |
| NEBNext FFPE DNA Repair Mix | 2 µl |
| Total | 60 µl |
Mezclar minuciosamente con la pipeta hasta obtener una mezcla homogénea y centrifugar brevemente.
En un termociclador con tapa térmica, incubar la(s) reacción(es) a 20 °C durante 5 minutos, a 65 °C durante 5 minutos y mantener a 4 °C.
Sacar la reacción del termociclador y colocar el/los tubo(s) en hielo.
En este punto, es posible transferir cada reacción a un tubo separado Eppendorf LoBind de 1,5 ml.
Resuspender las microesferas AMPure XP (AXP) mediante vórtex.
Añadir un volumen (1×) igual al de la muestra (60 µl) de microesferas AMPure XP (AXP) resuspendidas a la reacción de preparación de extremos y mezclar dando suaves golpecitos en el tubo con el dedo.
Incubar en el mezclador giratorio (p. ej., Hula mixer) durante 10 minutos a temperatura ambiente.
Preparar 2 ml de etanol al 80 % en agua sin nucleasas.
Debe haber suficiente para todas las muestras.
Centrifugar brevemente la muestra y sedimentar en una gradilla magnética durante 10 minutos hasta que el sobrenadante se vuelva claro e incoloro. Sin mover el tubo, retirar el sobrenadante con una pipeta y desechar.
Manteniendo el tubo en la gradilla, lavar las microesferas con 200 µl de etanol al 80 %, sin desplazar el sedimento. Retirar el etanol con una pipeta y desechar.
Repetir el paso anterior.
Centrifugar brevemente y colocar el tubo de nuevo en la gradilla magnética. Retirar con una pipeta cualquier residuo de etanol. Dejar secar el sedimento durante 30 segundos aproximadamente, sin dejar que se agriete.
Por cada muestra, quitar el tubo de la gradilla magnética y resuspender el sedimento en 20 µl de agua sin nucleasas. Incubar durante 5 minutos a temperatura ambiente.
Sedimentar las microesferas en una gradilla magnética, durante al menos 1 minuto, hasta que el eluido se vuelva claro e incoloro.
Extraer 20 µl de eluido de cada muestra y guardarlo en un tubo Eppendorf DNA Lobind de 1,5 ml.
Procesar las muestras por separado. En esta fase, aún no tienen códigos de barras.
Cuantificar 1 μl de cada muestra eluida con un fluorímetro Qubit.
Recomendamos realizar múltiples lecturas de Qubit (por triplicado) de cada una de las 3 muestras (3 muestras por celda de flujo) a fin de cuantificarlas con mayor exactitud, lo que será fundamental en la posterior normalización de cada muestra antes de añadir los códigos de barras.
Nota: tras la preparación de extremos se espera recuperar entre 500 y 700 ng por muestra.
A partir de los resultados de cuantificación, normalizar las muestras con la muestra de menor rendimiento de la siguiente manera:
1. Transferir 16 μl de la muestra de menor rendimiento a un tubo Eppendorf DNA LoBind de 1,5 ml.
2. Transferir una masa equivalente de cada una de las demás muestras a tubos individuales Eppendorf DNA LoBind de 1,5 ml.
3. Ajustar el volumen de cada una de las muestras a un total de 16 μl con agua sin nucleasas.
Tomar las muestras de ADN ya preparadas y proceder a la ligación directa con códigos de barras.
Opcional: en este paso, también es posible guardar la muestra a 4 °C hasta el día siguiente.
9. Ligación directa de códigos de barras
Material
- Kit Native barcodes (NB01-24)
- Microesferas AMPure XP (AXP)
- EDTA (ácido etilendiaminotetraacético)
- Short Fragment Buffer (SFB)
Consumibles
- Mezcla maestra de ligasa NEB Blunt/TA (NEB, M0367)
- Agua sin nucleasas (p.ej. Thermo Scientific, AM9937)
- Kit de ensayo Qubit™ dsDNA HS (Invitrogen, Q32851)
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Microcentrífuga
- Mezclador vórtex
- Mezclador rotatorio (tipo Hula mixer)
- Gradilla de separación magnética, compatible con tubos Eppendorf de 1,5 ml
- Bloque térmico
- Fluorímetro Qubit™ (o equivalente)
- Cubeta con hielo
- Pipeta multicanal y puntas
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P100
- Pipeta y puntas P20
- Pipeta y puntas P10
- Pipeta y puntas P2
Centrifugar brevemente la mezcla NEB Blunt/TA Ligase Master Mix, mezclar con la pipeta y colocarla en hielo.
Descongelar las microesferas AMPure XP (AXP) a temperatura ambiente, mezclar en vórtex y mantener a temperatura ambiente.
Descongelar el EDTA a temperatura ambiente y mezclar en vórtex. Centrifugar brevemente y poner en hielo.
Descongelar el amortiguador Long Fragment Buffer (SFB) a temperatura ambiente y mezclar en vórtex. Colocar en hielo.
Descongelar los códigos de barras Native Barcodes (NB01-24) a temperatura ambiente, mezclar individualmente con la pipeta, centrifugar brevemente y colocar en hielo.
Los pocillos de la placa de códigos de barras son de un solo uso. Compruebe que estén sellados y no los reutilice una vez perforados o abiertos.
Seleccionar un código de barras distinto por cada muestra que se procese en la misma celda de flujo. Etiquetar con códigos de barras hasta 3 muestras y agrupar en una celda de flujo PromethION.
Utilizar solo un código de barras por muestra.
Añadir los siguientes reactivos a cada tubo Eppendorf de 1,5 ml que contenga las muestras de partida normalizadas, en el orden indicado a continuación, mezclando bien con la pipeta tras cada adición:
| Reactivo | Volumen |
|---|---|
| ADN con los extremos preparados | 16 µl |
| Native Barcode (NB01-24) | 4 µl |
| Blunt/TA Ligase Master Mix | 20 µl |
| Total | 40 µl |
Mezclar la reacción minuciosamente con la pipeta y centrifugar brevemente.
Incubar a temperatura ambiente durante 20 minutos.
Añadir 4 µl de EDTA a cada muestra. Mezclar minuciosamente con la pipeta y centrifugar brevemente.
En este paso de añade EDTA, que detiene la reacción.
Agrupar las muestras etiquetadas (hasta tres a la vez) en un tubo Eppendorf DNA LoBind de 1,5 ml.
Resuspender las microesferas AMPure XP (AXP) mediante vórtex.
Añadir un volumen de 0,65× de microesferas AMPure XP (AXP) a la mezcla de muestras y homogeneizar con la pipeta.
Si se juntan 3 muestras (132 µl), el volumen de AXP necesario será de 86 µl.
Incubar en el mezclador giratorio (tipo Hula mixer) durante 10 minutos a temperatura ambiente.
En el siguiente paso de purificación se utiliza Short Fragment Buffer (SFB) en lugar de etanol al 80 %.
El uso de etanol produce resultados insuficientes.
Centrifugar brevemente la muestra y sedimentar en una gradilla magnética durante 5 minutos. Esperar hasta que el eluido se vuelva claro e incoloro y retirar el sobrenadante con una pipeta.
Lavar las microesferas con 500 µl de Short Fragment Buffer (SFB). Dar suaves golpes al tubo con el dedo, centrifugar brevemente, colocar de nuevo en la gradilla magnética y dejar que las microesferas sedimenten. Extraer el amortiguador con una pipeta y desechar.
Repetir el paso anterior.
Centrifugar brevemente y colocar el tubo de nuevo en la gradilla magnética. Retirar con una pipeta el resto del amortiguador.
Quitar el tubo de la gradilla y resuspender el sedimento en 32 µl de agua sin nucleasas dando suaves golpes al tubo con el dedo.
Incubar durante 10 minutos a 37 °C. Cada 2 minutos, mezclar dando suaves golpecitos al tubo con el dedo durante 10 segundos, a fin de favorecer la elución de ADN.
Sedimentar las microesferas en una gradilla magnética hasta que el eluido se vuelva claro e incoloro.
Extraer y guardar 32 µl de eluido en un tubo Eppendorf DNA Lobind de 1,5 ml.
Cuantificar 1 μl de muestra eluida con un fluorímetro Qubit.
Nota: por lo general, se recuperan entre 600 y 800 ng de ADN tras la ligación directa de los códigos de barras.
Tomar la biblioteca de ADN con los códigos de barras añadidos y proceder a la ligación de los adaptadores y purificación. En este punto, también es posible conservar la muestra a 4 °C durante la noche.
10. Ligación de los adaptadores y purificación
Material
- Long Fragment Buffer (LFB)
- Elution Buffer (EB)
- Native Adapter (NA)
- Microesferas AMPure XP (AXP)
Consumibles
- Módulo NEBNext® Quick Ligation (NEB, E6056)
- Kit de ensayo Qubit™ dsDNA HS (Invitrogen, Q32851)
- Tubos de ensayo Qubit™ (Invitrogen, Q32856)
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Microcentrífuga
- Mezclador vórtex
- Mezclador rotatorio (tipo Hula mixer)
- Gradilla de separación magnética, compatible con tubos Eppendorf de 1,5 ml
- Bloque térmico
- Cubeta con hielo
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P100
- Pipeta y puntas P20
- Pipeta y puntas P10
- Fluorímetro Qubit™ (o equivalente)
El adaptador utilizado en este protocolo —Native Adapter (NA)— no es intercambiable con otros adaptadores de secuenciación.
Verificar la celda de flujo
Recomendamos verificar la celda de flujo antes de iniciar la ligación de los adaptadores y comprobar que la celda de flujo dispone de número de poros suficiente para realizar una secuenciación de calidad.
Antes de utilizarlas, sacar las celdas de flujo de la nevera y de su embalaje y dejarlas a temperatura ambiente durante 30 minutos.
En ambientes húmedos, es posible que se forme condensación en la celda de flujo. Inspeccione los contactos dorados de las caras superior e inferior de la celda de flujo y si la hubiera, límpiela con una toallita sin pelusa. Compruebe que la almohadilla térmica (gris oscuro) se encuentra en la cara inferior de la misma.
Encontrará más información en el documento de comprobación de celdas de flujo.
Preparar el módulo NEBNext Quick Ligation Reaction Module de acuerdo con las instrucciones del fabricante y colocar en hielo:
Descongelar el amortiguador NEBNext Quick Ligation Reaction Buffer a temperatura ambiente.
Centrifugar brevemente los reactivos durante 5 segundos.
Mezclarlos con la pipeta 10 veces hasta obtener una mezcla homogénea.
Colocar la ligasa Quick T4 DNA Ligase en hielo. NO agitar en vórtex.
Nota: el amortiguador NEBNext Quick Ligation Reaction Buffer (5x) quizás tenga un poco de precipitado. Dejar que la mezcla alcance la temperatura ambiente y mezclar con la pipeta varias veces hasta disolverlo; agitar en vórtex durante varios segundos hasta que esté completamente mezclado.
No mezclar en vórtex la ligasa Quick T4 DNA Ligase.
Centrifugar el vial Native Adapter (NA), mezclar con la pipeta y poner en hielo.
Descongelar el amortiguador Elution Buffer (EB) a temperatura ambiente y mezclar en vórtex. Centrifugar brevemente y poner en hielo.
Descongelar el amortiguador Long Fragment Buffer (LFB) a temperatura ambiente; mezclar en vórtex y colocar en hielo.
En un tubo de 1,5 ml Eppendorf DNA LoBind, mezclar en el siguiente orden:
| Reactivo | Volumen |
|---|---|
| Bibliotecas con códigos de barras agrupadas de tres en tres | 30 µl |
| Native Adapter (NA) | 5 µl |
| NEBNext Quick Ligation Reaction Buffer (5X) | 10 µl |
| Quick T4 DNA Ligase | 5 µl |
| Total | 50 µl |
Mezclar la reacción minuciosamente con la pipeta y centrifugar brevemente.
Incubar durante 20 minutos a temperatura ambiente.
En el siguiente paso de purificación, lavar las microesferas con Long Fragment Buffer (LFB) en lugar de etanol al 80 %. El uso de etanol perjudicaría la reacción.
Resuspender las microesferas AMPure XP (AXP) mediante vórtex.
Añadir 0,5× (25 µl) de microesferas de resuspendidas AMPure XP (AXP) a la reacción y homogeneizar con la pipeta.
Incubar en el mezclador giratorio (p. ej., Hula mixer) durante 10 minutos a temperatura ambiente.
Centrifugar brevemente la muestra y precipitar en una gradilla magnética. Sin mover el tubo, retirar el sobrenadante con una pipeta.
Lavar las microesferas con 250 μl de Long Fragment Buffer (LFB). Dar suaves golpecitos al tubo con el dedo, centrifugar brevemente, colocar de nuevo en la gradilla magnética y dejar que las microesferas precipiten durante al menos 5 minutos. Retirar el sobrenadante con una pipeta y desechar.
Importante: tenga cuidado al extraer el sobrenadante; la viscosidad del amortiguador favorece la pérdida de microesferas del sedimento.
Repetir el paso anterior.
Centrifugar brevemente y colocar el tubo de nuevo en la gradilla magnética. Retirar con una pipeta el resto del sobrenadante. Dejar secar el sedimento durante 30 segundos aproximadamente, sin dejar que se agriete.
Sacar el tubo de la gradilla magnética y resuspender el sedimento en 35 µl de Elution Buffer (EB).
Centrifugar brevemente e incubar durante 10 minutos a 37 °C. Cada 2 minutos, dar suaves golpes al tubo con el dedo durante 10 segundos a fin de favorecer la elución de ADN.
Sedimentar las microesferas en una gradilla magnética durante al menos 1 minuto, hasta que el eluido se vuelva claro e incoloro.
Extraer y conservar 35 μl del eluido que contiene la biblioteca de ADN en un tubo nuevo Eppendorf DNA LoBind de 1,5 ml.
Nota: deshechar las microesferas sedimentadas.
Cuantificar 1 μl de muestra eluida con un fluorímetro Qubit.
Por lo general, tras la ligación del adaptador se recuperan entre 300 y 500 ng de ADN.
Nota: cargar menos de 250 ng reduce la ocupación de poros y dificulta alcanzar el objetivo de datos esperado.
Conservar la biblioteca en hielo o a 4 °C hasta el momento de cargarla en la celda de flujo.
Una vez preparada, recomendamos cargar la biblioteca lo antes possible.
11. Acondicionamiento y carga de celdas de flujo PromethION
Material
- Flow Cell Flush (FCF)
- Flow Cell Tether (FCT)
- Library Beads (LIB)
- Sequencing Buffer (SB)
Consumibles
- Celdas de flujo PromethION (FLO-PRO114M)
- Tubos Eppendorf DNA LoBind de 1,5 ml
Instrumental
- Dispositivo PromethION
- Pantalla protectora celdas de flujo PromethION
- Mezclador vórtex
- Microcentrífuga
- Cubeta con hielo
- Pipeta y puntas P1000
- Pipeta y puntas P200
- Pipeta y puntas P100
- Pipeta y puntas P20
Este kit es compatible solo con celdas de flujo R10.4.1 (FLO-PRO114M).
Recomendamos sacar las celdas de flujo de la nevera y de su embalaje y dejarlas a temperatura ambiente durante 30 minutos, antes de insertarlas en el dispositivo.
En entornos húmedos es posible que se forme condensación. Inspeccione las clavijas doradas del conector, situadas en la parte superior e inferior de la celda de flujo, en busca de condensación y si la hubiera, límpiela con una toallita sin pelusa. Compruebe que la almohadilla térmica (color negro) esté enganchada en la parte posterior.
Descongelar los viales Sequencing Buffer (SB), Library Beads (LIB), Flow Cell Tether (FCT) y Flow Cell Flush (FCF) a temperatura ambiente y mezclar en vórtex. Centrifugar brevemente y poner en hielo.
Preparar la mezcla de acondicionamiento en un tubo adecuado al número de celdas de flujo que se vayan a purgar. Una vez añadidos, mezclar bien con un breve vórtex.
| Reactivo | Volumen por celda de flujo |
|---|---|
| Flow Cell Tether (FCT) | 30 µl |
| Flow Cell Flush (FCF) | 1170 µl |
| Total volume | 1 200 µl |
Cargar la(s) celda(s) de flujo en los puertos de acople:
Comprobar que la almohadilla térmica negra de la parte posterior de la celda de flujo no esté rota ni deformada
En el PromethION 24:
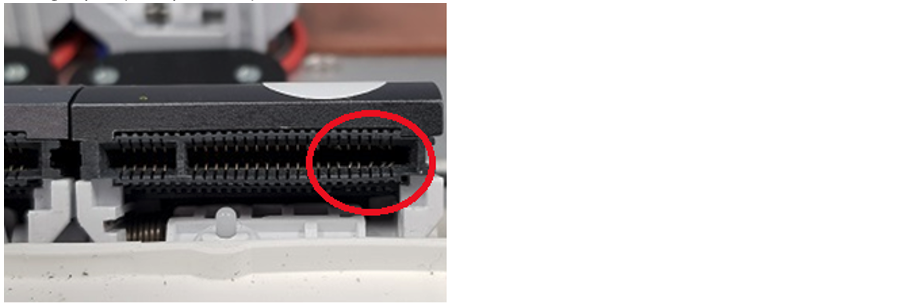
- Alinear la celda de flujo con el conector, horizontal y verticalmente, e insertarla suavemente en la posición.
- Presionar con firmeza hasta que el cierre encaje y haga clic.


En el PromethION 2 Integrated:
- Colocar la celda de flujo en horizontal sobre la placa metálica.
- Deslizar hacia el puerto de acople hasta que las clavijas doradas queden ocultas.
- Presionar con firmeza hacia la posición de carga hasta que se oiga un clic.

Si la celda de flujo se inserta en el ángulo equivocado existe el riesgo de dañar las clavijas del PromethION y afectar los resultados de secuenciación. Si observa que las clavijas están dañadas, contacte con el servicio de asistencia en support@nanoporetech.com.
Antes de cargar la biblioteca, realice una comprobación de la celda de flujo a fin de evaluar el número de poros disponible.
Si se ha comprobado con anterioridad, este paso puede omitirse.
Encontrará más información en las instrucciones de comprobación de celdas de flujo del protocolo de MinKNOW.
Deslizar la tapa del puerto de entrada en el sentido de las agujas del reloj.
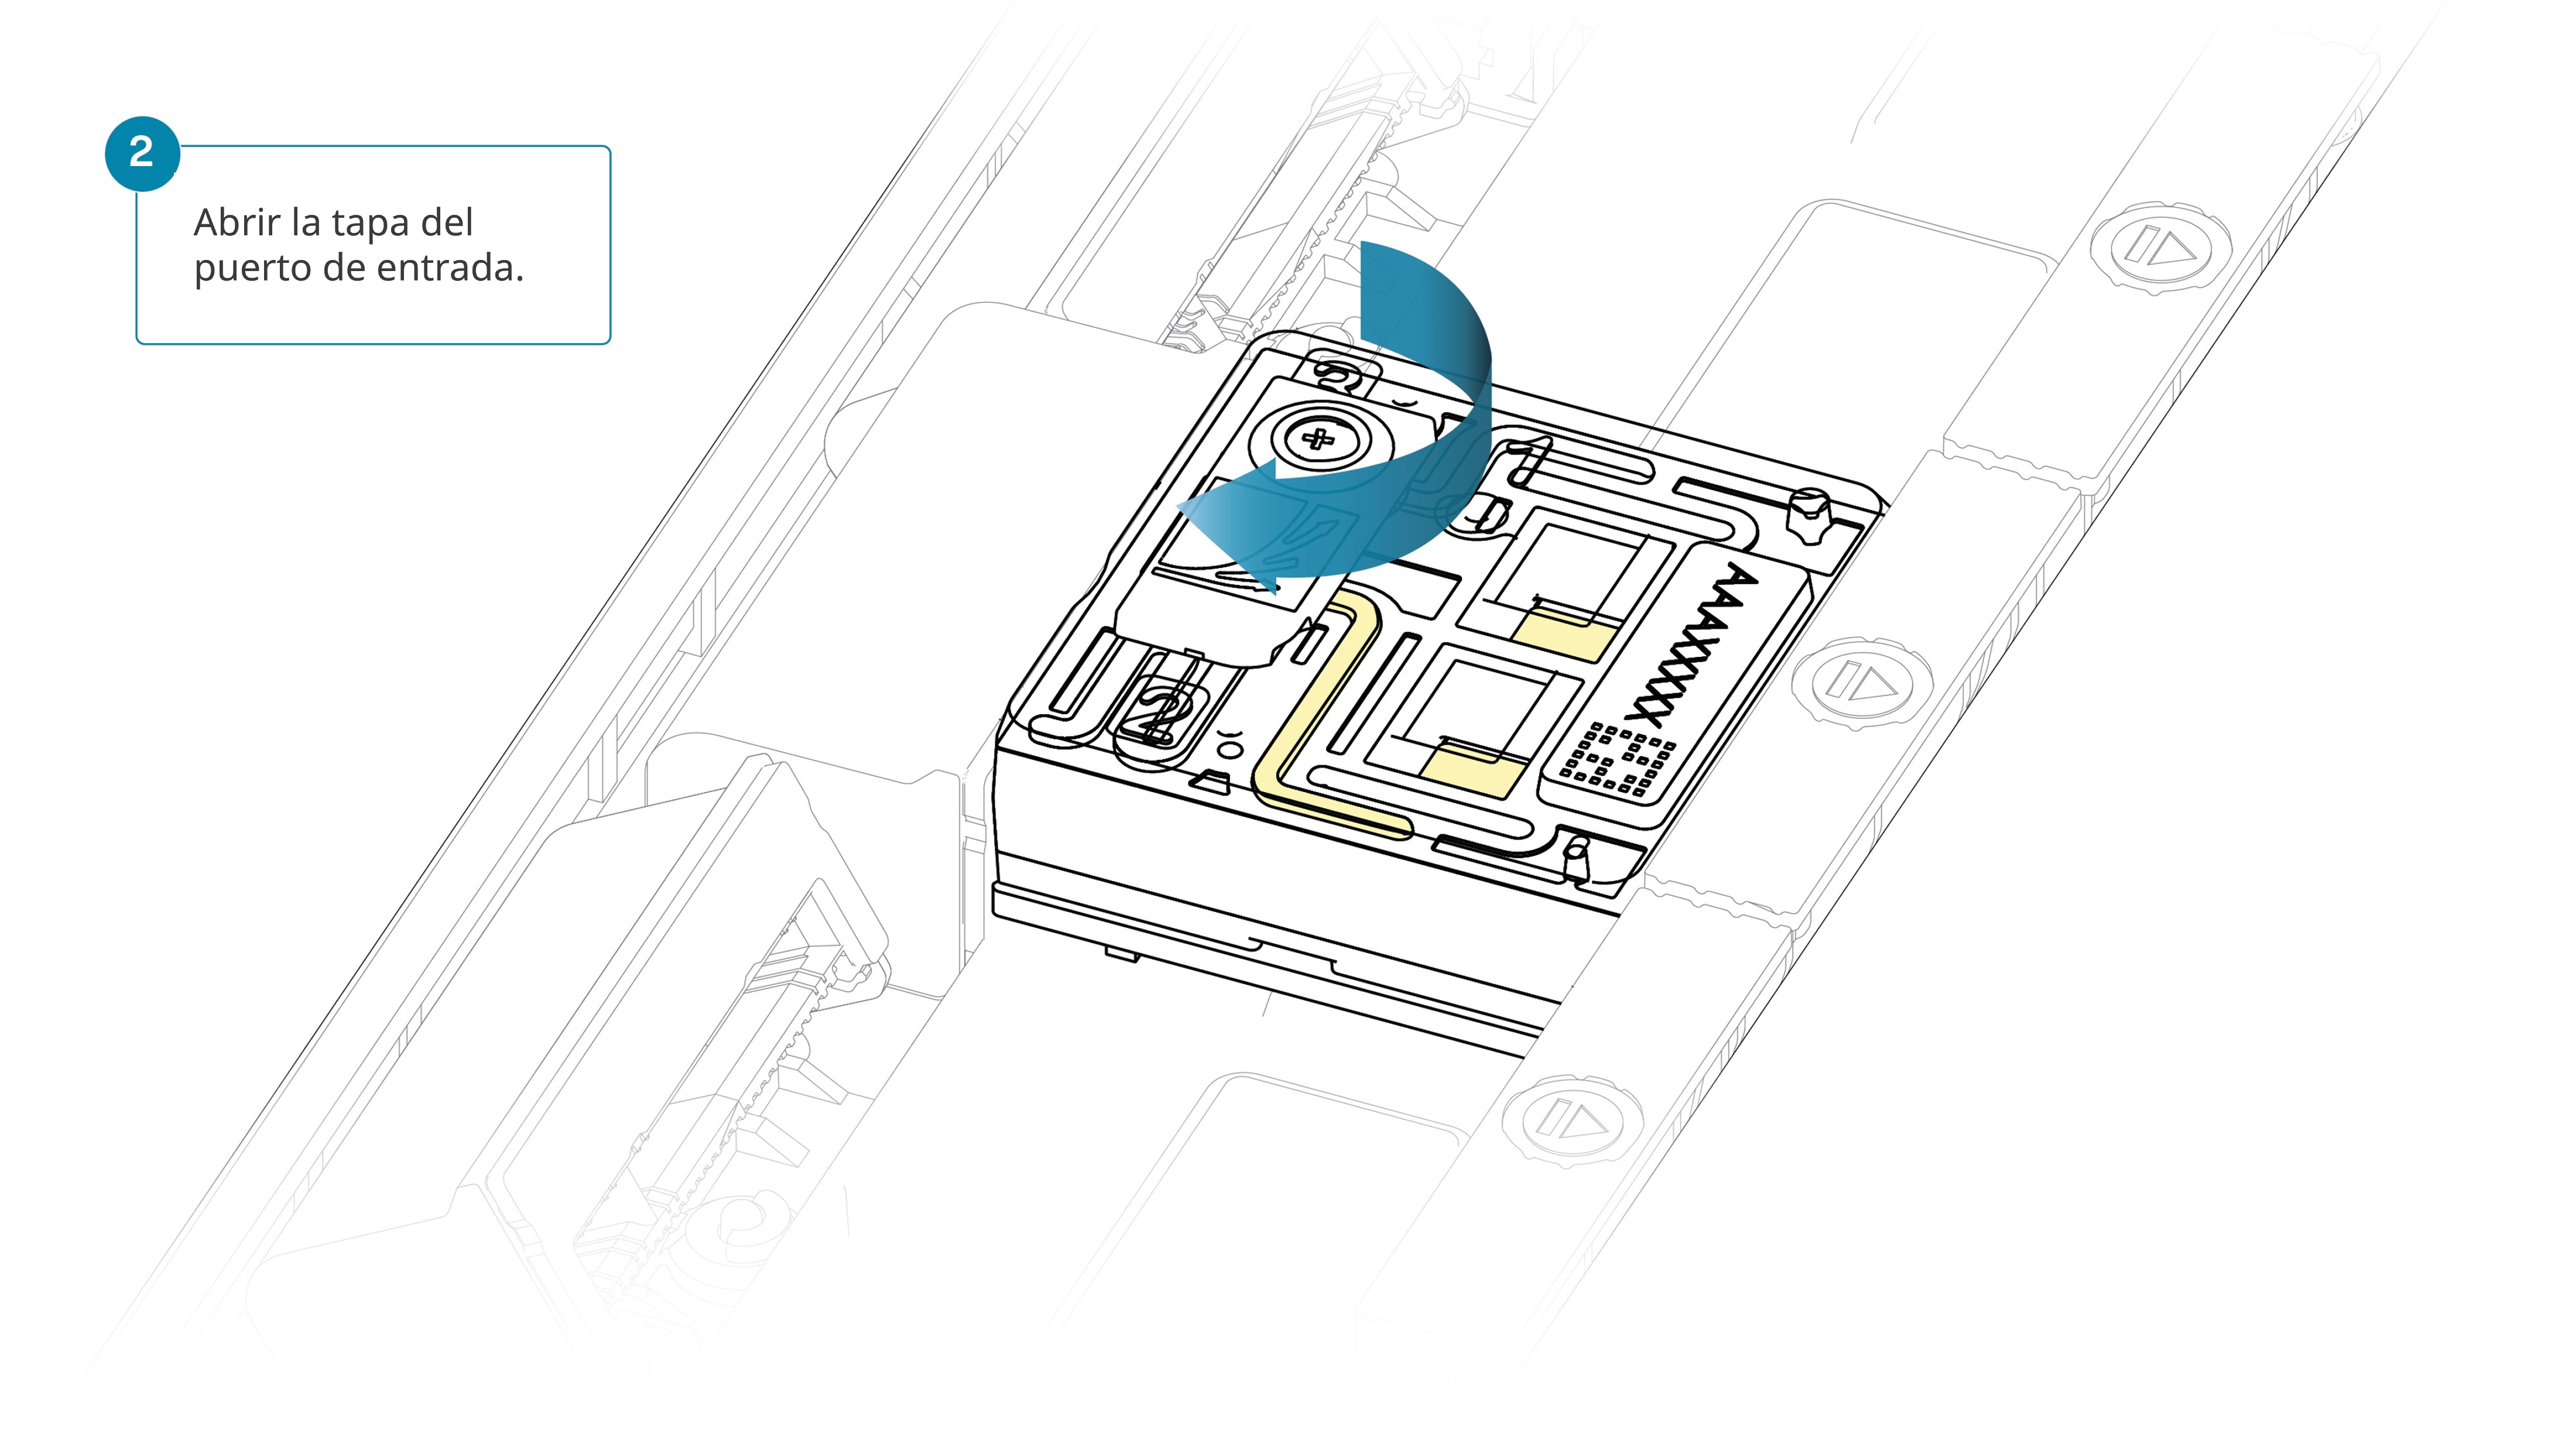
Tenga cuidado al extraer el amortiguador. No retire más de 20-30 μl y compruebe que cubra la matriz de poros en todo momento. La introducción de burbujas de aire en la matriz daña los poros de manera irreversible.
Tras abrir el puerto de entrada, aspirar una pequeña cantidad de fluido a fin de eliminar las burbujas de aire:
- Ajustar una pipeta P1000 a 200 μl.
- Introducir la punta en el puerto de entrada.
- Girar la rueda hasta que el indicador de volumen marque 220-230 μl o hasta que se vea una pequeña cantidad entrar en la punta de la pipeta.

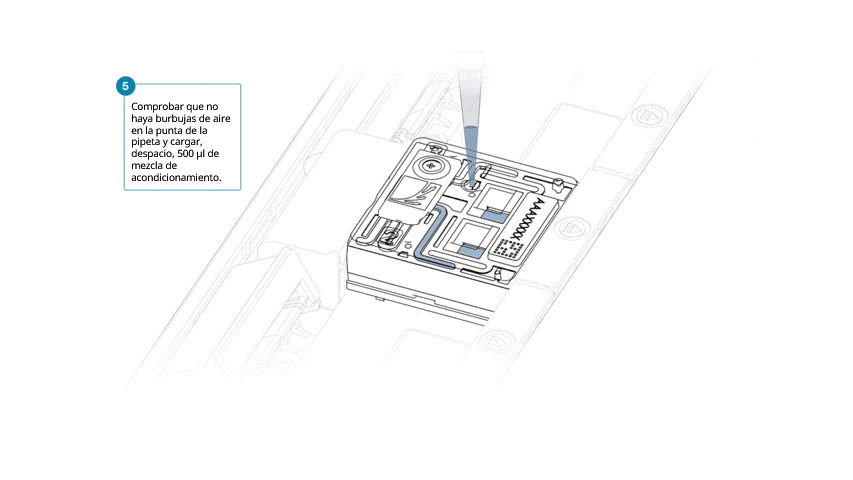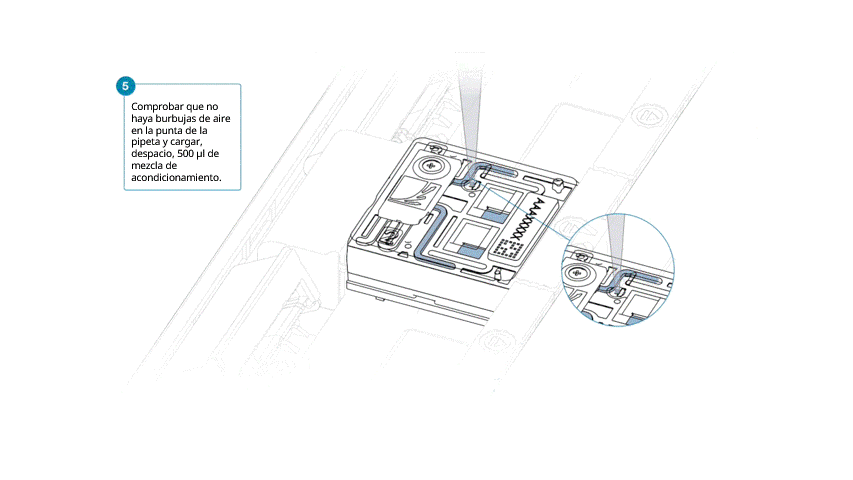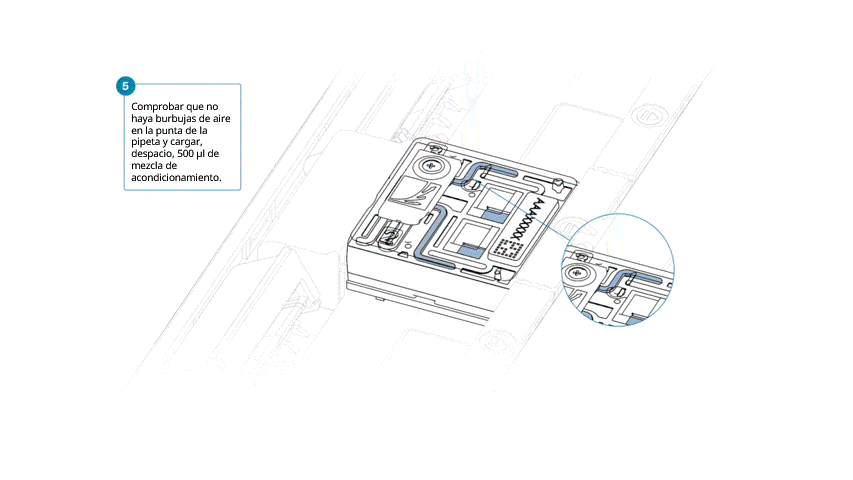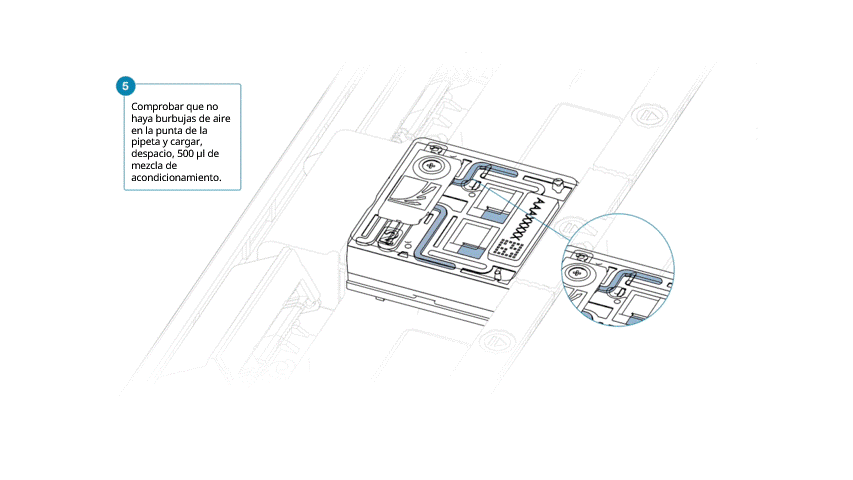
Cargar 500 μl de mezcla de acondicionamiento por el puerto de entrada, evitando introducir burbujas de aire. Esperar cinco minutos. Mientras tanto, preparar la biblioteca siguiendo los siguientes pasos del protocolo.

Mezclar minuciosamente con la pipeta el contenido del vial Library Beads (LIB).
El vial Library Beads (LIB) contiene microesferas en suspensión que sedimentan muy rápido; por eso es crucial mezclarlas justo antes de su uso.
Recomendamos utilizar Library Beads (LIB) en la mayoría de experimentos de secuenciación.
En un tubo Eppendorf DNA LoBind de 1,5 ml preparar la biblioteca de la siguiente manera:
| Reactivo | Volumen por celda de flujo |
|---|---|
| Sequencing Buffer (SB) | 100 µl |
| Library Beads (LIB) bien mezclado antes de su uso | 68 µl |
| Biblioteca de ADN | 32 µl |
| Total | 200 µl |
Nota: se ha aumentado el volumen de carga de la biblioteca, con el fin de mejorar la cobertura de la matriz.
Terminar de acondicionar la celda de flujo cargando lentamente 500 µl de mezcla de preparación por el puerto de entrada.
Mezclar la biblioteca aspirando y dispensando el contenido con cuidado.
A continuación, cargar 200 μl por el puerto de entrada con una pipeta p1000.

Cerrar la válvula.

A fin de obtener un rendimiento de secuenciación óptimo, colocar la pantalla protectora sobre la celda de flujo en cuanto se cargue la biblioteca.
Recomendamos no retirarla mientras la biblioteca esté cargada ni durante los lavados o recargas. Se retira una vez se haya extraído la biblioteca.
Si se ha retirado con anterioridad, se instala de la siguiente manera:
- Alinear la abertura de la pantalla con la tapa del puerto de entrada. El borde delantero de la pieza debe quedar por encima del identificador de la celda de flujo.
- Presionar la pantalla protectora con firmeza alrededor de la tapa del puerto de entrada. Cuando el clip del puerto de entrada encaje bajo la tapa, se producirá un clic.


Cuando esté listo para empezar un experimento de secuenciación en MinKNOW, cerrar la tapa del dispositivo.
Tras cargar las celdas de flujo, esperar al menos 10 minutos antes de iniciar un experimento, ayuda a aumentar el rendimiento de la secuenciación.
12. Adquisición de datos e identificación de bases
Cómo empezar a secuenciar
MinKNOW gestiona el dispositivo de secuenciación, la adquisición de datos y la identificación de bases en tiempo real.
En la documentación del PromethION 24 o del PromethION 2 Integrated encontrará instrucciones de configuración del dispositivo y de la secuenciación. En ambos dispositivos se usan los mismos parámetros de secuenciación.
Antes de empezar
Antes de iniciar la secuenciación:
Comprobar que el archivo FASTA de referencia del panel (véase «Genoma de referencia» en el apartado 4) y el archivo BED de enriquecimiento se encuentran en el dispositivo.
Comprobar que hay espacio de almacenamiento suficiente en el dispositivo por cada celda de flujo.
Decidir si se activa la opción «Identificar bases solo en las lecturas de las regiones de interés», como se describe a continuación.
Identificación de bases en tiempo real e Identificar bases solo en las lecturas de las regiones objetivo
Recomendamos identificar las bases en tiempo real con el modelo de gran precisión (HAC) y utilizar BAM como formato de salida. El parámetro «Identificar bases solo en las lecturas de las regiones de interés» de MinKNOW determina en qué lecturas se identifican las bases durante la secuenciación. La opción adecuada depende de si se necesitan las lecturas que rechaza el muestreo adaptativo.
| Identificar bases solo en las lecturas de las regiones de interés | Lecturas identificadas durante la secuenciación | Celdas de flujo simultáneas |
|---|---|---|
| Desactivado | Todas las lecturas, incluso las lecturas cortas rechazadas por el muestreo adaptativo. Además de los datos de las regiones de interés, las lecturas rechazadas ofrecen una visión del genoma completo y de su metilación a poca profundidad. | Menos, porque se identifican las bases de todas las lecturas |
| Activado | Solo las lecturas de las regiones de interés. Las lecturas rechazadas se guardan en la carpeta pod5skip dentro de la carpeta de la secuenciación y, si hace falta, se les puede aplicar la identificación de bases posejecución. | Todas las posiciones del dispositivo |
El número de celdas de flujo cuyas bases identifica cada dispositivo en tiempo real, con y sin el parámetro «Identificar bases solo en las lecturas de las regiones de interés», se indica en el apartado Device limits de la guía técnica de muestreo adaptativo. Si se secuencian más celdas de flujo de las que el dispositivo puede procesar en tiempo real, la identificación de bases se retrasa con respecto a la secuenciación y es posible que disminuya el enriquecimiento.
Si se quiere secuenciar más celdas de flujo a la vez y conservar igualmente los datos de las lecturas no seleccionadas, establecer el parámetro «Identificar bases solo en las lecturas de las regiones de interés» en Activado e identificar las bases de las lecturas rechazadas después de la secuenciación. Este proceso requiere tiempo adicional en el dispositivo una vez finalizada la secuenciación. Las instrucciones se encuentran en «Identificación de bases de las lecturas rechazadas tras la secuenciación», en el apartado «Datos de salida y análisis» más adelante.
Con el formato POD5 desactivado, no se conserva la señal sin procesar de las lecturas identificadas.
Si tiene previsto identificar las bases de las lecturas rechazadas tras la secuenciación, active la opción POD5. Las lecturas rechazadas que omite la opción Identificar bases solo en las lecturas de las regiones de interés se conservan en la carpeta pod5skip.
Configurar un experimento de secuenciación en MinKNOW
Seleccionar Iniciar secuenciación en MinKNOW; a continuación, introducir la posición de la celda de flujo, el nombre del experimento y el ID de la muestra.
El ID de la muestra se aplica a toda la celda de flujo no a cada muestra; las tres muestras se identifican por su número de código de barras (por ejemplo, barcode01, barcode02 y barcode03) en las carpetas y archivos de salida. Tome nota de qué muestra corresponde a cada código de barras.
Si prefiere dar un nombre a cada muestra, parta de una hoja de muestras como se explica más abajo en la sección Opcional: partir de una hoja de muestras.Aplicar los parámetros indicados a continuación. Dejar el resto en sus valores predeterminados.
| Pantalla | Parámetro | Valor |
|---|---|---|
| Kit | Selección de kit | Native Barcoding Kit 24 V14 (SQK-NBD114.24) o Native Barcoding Kit 96 V14 (SQK-NBD114.96) |
| Configuración de la secuenciación | Bases modificadas | Activado, con los contextos CG 5mC y 5hmC seleccionados |
| Alineamiento | Activado. Cargar el archivo FASTA de referencia de su panel. Si se usa el panel de cáncer hereditario, cargar el archivo GIAB v3; si se usa un panel personalizado, cargar el archivo de la versión correspondiente (véase «Genoma de referencia» en la sección 4). | |
| Muestreo adaptativo | Activado, con Enriquecimiento seleccionado. Cargar el archivo BED de enriquecimiento (*_enrichment.bed) y el mismo archivo de referencia FASTA. | |
| Identificar bases solo en las lecturas de las regiones de interés | Desactivado o activado, según se describe arriba | |
| Salida | FASTQ | Desactivado |
| POD5 | Desactivado o activado si se tiene previsto identificar las bases de las lecturas rechazadas después de la secuenciación |
- Iniciar la secuenciación
Opcional: partir de una hoja de muestras
Partir de una hoja de muestras permite dar un nombre a cada una de las tres muestras, que aparece en las carpetas y los archivos de salida con el número de código de barras. Utilizar la misma configuración indicada en la tabla anterior.
Preparar un archivo CSV con una fila por código de barras. Debe contener las siguientes columnas:
- experiment_id: el nombre del experimento, el mismo en todas las filas.
- kit: SQK-NBD114.24.
- código de barras: por ejemplo, barcode01.
- alias: el nombre de la muestra asociado a ese código de barras
Los nombres de muestras en la columna alias solo deben contener letras, números, guiones, guiones bajos y puntos, sin espacios y deben tener entre 1 y 40 caracteres. - position_id: la posición en el dispositivo, o bien
- flow_cell_id: el ID impreso en la celda de flujo.
Guardar el archivo con la extensión .csv visible; de lo contrario, MinKNOW no lo reconocerá.
En MinKNOW, seleccionar Partir de una hoja de muestras en lugar de Iniciar secuenciación y elegir el archivo CSV. La posición de la celda de flujo, el nombre del experimento y de las muestras se leen del archivo, no hace falta introducirlos en la pantalla. A continuación, aplicar la configuración indicada en la tabla anterior.
Las demás opciones de la hoja de muestras se explican en la sección sobre la hoja de muestras de la documentación de MinKNOW.
No recomendamos secuenciar y realizar análisis de datos a la vez en el mismo dispositivo.
Recomendamos encarecidamente no realizar a la vez la secuenciación y la identificación de bases; de lo contrario, es posible que la capacidad de cálculo del dispositivo no alcance a cubrir las exigencias de ambos procesos. Comprobar que la secuenciación haya finalizado antes de iniciar el análisis de datos y no iniciar una secuenciación mientras el dispositivo esté analizando los datos.
13. Datos de salida y análisis
Datos de salida
Al final de la secuenciación, los datos de cada una de las tres muestras está en su propio carpeta de código de barras. Cada archivo BAM contiene las lecturas identificadas y alineadas con el archivo de referencia FASTA que se cargó en MinKNOW. Las de bases modificadas (5mC y 5hmC en contexto CpG), solo se guardan en los registros de lectura si al configurar la secuenciación se activó la función de identificación de bases modificadas.
Con la función Identificar bases solo en las lecturas de las regiones de interés desactivada, los archivos BAM también contiene las lecturas cortas rechazadas por el muestreo adaptativo. Con la función activada, las lecturas rechazadas no se identifican y se escriben en la carpeta pod5skip.
| Salida | Descripción |
|---|---|
| Archivos BAM alineados, una carpeta por código de barras | Lecturas identificadas y alineadas de cada muestra, con las bases modificadas si se activó la identificación. |
| Resumen e informe de secuenciación | Parámetros globales de secuenciación, como la longitud de lectura, el rendimiento y las decisiones del muestreo adaptativo. |
Análisis
Calcular la cobertura de las regiones objetivo y limitar a ellas la identificación de variantes con *_analysis.bed, en lugar de *_enrichment.bed. Si se calcula la cobertura con el archivo BED de enriquecimiento, el resultado incluye el margen y deja de describir las regiones objetivo. Utilizar _exons.bed cuando se indica la cobertura por exón.
En paneles personalizados de línea germinal, la identificación de variantes, la determinación de la fase de variantes y el análisis de metilación se realizan por muestra con el flujo de trabajo wf-human-variation en la aplicación EPI2ME Desktop o en la línea de comandos, a partir de los archivos BAM de un código de barras, el archivo de referencia FASTA y el archivo BED de análisis.
Con el Panel de cáncer hereditario, utilizar el flujo bioinformático wf-hereditary-cancer.
14. Reutilización y devolución de celdas de flujo
Con este método, no recomendamos lavar y reutilizar las celdas de flujo.
Debido al prolongado tiempo de secuenciación, no recomendamos reutilizar las celdas de flujo que se utilicen en este protocolo.
Reutilizar las celdas de flujo en experimentos posteriores provoca que se generen datos insuficientes, lo que dificulta su análisis.
Siga el procedimiento de devolución y envíe las celdas de flujo a Oxford Nanopore, que se encargará de su reciclaje.
Envuelva las celdas de flujo en blíster en el que las recibió, que las protegerá durante el transporte.
Aquí encontrará las instrucciones de devolución.
Ante cualquier problema o duda acerca del experimento de secuenciación, consulte la sección Resolución de problemas a continuación.
15. Problemas durante la extracción de ADN y la preparación de la biblioteca
A continuación hay una lista de los problemas más frecuentes, con algunas posibles causas y soluciones propuestas.
También disponemos de una sección de Preguntas frecuentes (FAQ) en la sección Support de la comunidad Nanopore.
Si ha probado las soluciones propuestas y los problemas persisten, póngase en contacto con el departamento de Asistencia técnica, bien por correo electrónico (support@nanoporetech.com) o a través del chat en directo de la comunidad Nanopore.
Baja calidad de la muestra
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Baja pureza del ADN (la lectura del Nanodrop del ADN con una relación OD 260/280 es <1,8 y OD 260/230 es <2,0-2,2) | El método de extracción de ADN no proporciona la pureza necesaria | Los efectos de los contaminantes se muestran en el documento Contaminants. Probar con otro método de extracción que no provoque el arrastre de contaminantes. Considere realizar un paso adicional de limpieza con microesferas AMPure. |
Escasa recuperación de ADN tras la limpieza con microesferas AMPure
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Escasa recuperación | Pérdida de ADN debido a una proporción de microesferas AMPure por muestra inferior a lo previsto. | 1. Las microesferas AMPure precipitan con rapidez; antes de añadirlas a la muestra deben estar bien resuspendidas. 2. Si la proporción de microesferas por muestra es inferior a 0.4:1, los fragmentos de ADN, sean del tamaño que sean, se perderán durante la limpieza. |
| Escasa recuperación | Los fragmentos de ADN son más cortos de lo esperado | Cuanto menor sea la proporción de microesferas AMPure por muestra, más rigurosa será la selección de fragmentos largos frente a los cortos. Determinar siempre la longitud de la muestra de ADN en un gel de agarosa u otros métodos de electroforesis en gel y a continuación, calcular la cantidad adecuada de microesferas AMPure que se debe utilizar. 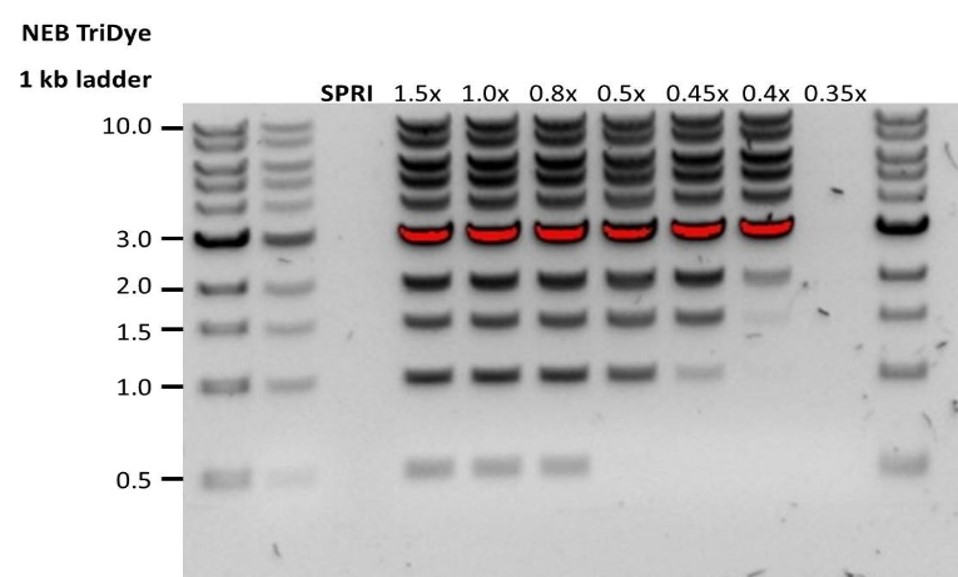 |
| Escasa recuperación tras la preparación de extremos | En el paso de lavado se utilizó etanol en una concentración inferior al 70 % | Si se utiliza etanol a una concentración inferior al 70 %, el ADN se eluye de las microesferas. Compruebe que utiliza el porcentaje correcto. |
16. Problemas durante el experimento de secuenciación
A continuación, hay una lista de los problemas más frecuentes, con algunas posibles causas y soluciones propuestas.
También disponemos de una sección de preguntas frecuentes (FAQ) en la sección Support de la comunidad Nanopore.
Si ha probado las soluciones propuestas y los problemas aún persisten, póngase en contacto con el departamento de Asistencia técnica, bien por correo electrónico (support@nanoporetech.com) o a través del chat de la comunidad Nanopore.
Menos poros al inicio de la secuenciación que tras la evaluación de la celda de flujo
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| MinKNOW presentó al inicio de la secuenciación un número de poros inferior al indicado durante la evaluación de la celda de flujo | Se introdujo una burbuja de aire en la matriz de nanoporos. | Tras comprobar la celda de flujo y antes de acondicionarla, es imprescindible quitar las burbujas de aire que haya cerca del puerto de purgado. Si no se quitan, las burbujas son capaces de desplazarse hacia la matriz de nanoporos y dañar los nanoporos expuestos al aire de manera irreversible. En el vídeo Cómo cargar una celda de flujo PromethION se muestran algunas buenas prácticas evitar que esto ocurra. |
| MinKNOW presentó al inicio de la secuenciación un número de poros inferior al indicado durante la comprobación de la celda de flujo | La celda de flujo no está colocada correctamente. | Detener el ciclo de secuenciación, quitar la celda de flujo del dispositivo e insertarla de nuevo. Comprobar que está firmemente asentada en el dispositivo y que ha alcanzado la temperatura deseada. Si procede, probar con una posición diferente (GriION/PromethION). |
| MinKNOW presentó al inicio de la secuenciación un número de poros inferior al indicado durante la evaluación de la celda de flujo | La presencia de contaminantes en la biblioteca ha dañado o bloqueado los poros. | El recuento de poros durante la evaluación de la celda de flujo se efectúa utilizando las moléculas de ADN del control de calidad presentes en el amortiguador de almacenamiento. Al inicio de la secuenciación, se utiliza la misma biblioteca a fin de calcular el número de poros activos. Por este motivo, se estima que existe una variabilidad del 10 % en el número de poros detectados. Tener un número de poros considerablemente inferior al inicio de la secuenciación suele estar relacionado con la presencia de contaminantes en la biblioteca que hayan dañado las membranas o bloqueado los poros. En algunos casos, recomendamos emplear métodos alternativos de extracción o purificación de ADN/ARN a fin de mejorar la pureza del material de partida. Los efectos de los contaminantes se muestran en la página Contaminants. Probar con un método de extracción diferente que no provoque el arrastre de contaminantes. |
Error en el script de MinKNOW
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| MinKNOW muestra el mensaje "Error en el script" | Reiniciar el ordenador y reiniciar MinKNOW. Si el problema persiste, reúna los archivos de registro de MinKNOW y contacte con el departamento de Asistencia técnica. Si no dispone de otro dispositivo de secuenciación, recomendamos que guarde la celda de flujo cargada a 4 °C y contacte con el servicio de asistencia técnica, que proporcionará instrucciones de almacenamiento adicionales. |
Ocupación de poros por debajo del 40 %
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Ocupación de poros inferior al 40 % | No se cargó suficiente biblioteca en la celda de flujo. | En protocolos de secuenciación de genoma humano, deben cargarse 250-300 ng de biblioteca de buena calidad en una celda de flujo R10.4.1; así, la ocupación de poros se mantendrá elevada. |
| Ocupación de poros próxima a 0 | Tras la ligación de los adaptadores, en lugar de utilizar Long Fragment Buffer (LFB) o Short Fragment Buffer (SFB) se utilizó etanol. | El etanol desnaturaliza la proteína motor en los adaptadores de secuenciación. Después de la ligación de los adaptadores se debe utilizar Long Fragment Buffer (LFB) o Short Fragment Buffer (SFB). |
| Ocupación de poros próxima a 0 | No hay anclaje en la celda de flujo. | Los anclajes se añaden durante el acondicionamiento de la celda de flujo (tubo FCT). Añadir FCT al vial FCF antes de acondicionar la celda de flujo. |
Longitud de lectura más corta de lo esperado
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Longitud de lectura más corta de lo esperado | Fragmentación no deseada de la muestra de ADN | La longitud de lectura refleja la longitud del fragmento de la muestra de ADN. La muestra de ADN tiende a fragmentarse durante la extracción y la preparación de la biblioteca. 1. Consulte la sección de buenas prácticas de extracción en la página Extraction Methods de la comunidad Nanopore. 2. Visualizar la distribución de longitudes de fragmentos de las muestras de ADN en un gel de agarosa antes de proceder a la preparación de la biblioteca. 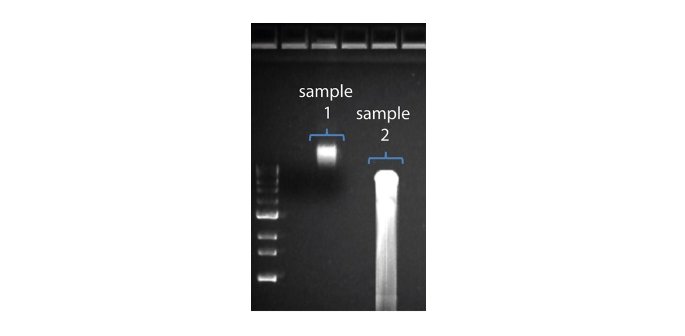 En la imagen superior, la muestra 1 contiene un elevado peso molecular, mientras que la muestra 2 se ha fragmentado. 3. Durante la preparación de la biblioteca, evite pipetear y agitar en vórtex al mezclar los reactivos. Dar suaves golpecitos con el dedo o invertir el vial es suficiente. |
Gran proporción de poros inutilizables
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
Gran proporción de poros inutilizables (se muestran en azul en el panel de canales y en el gráfico de actividad de poros) 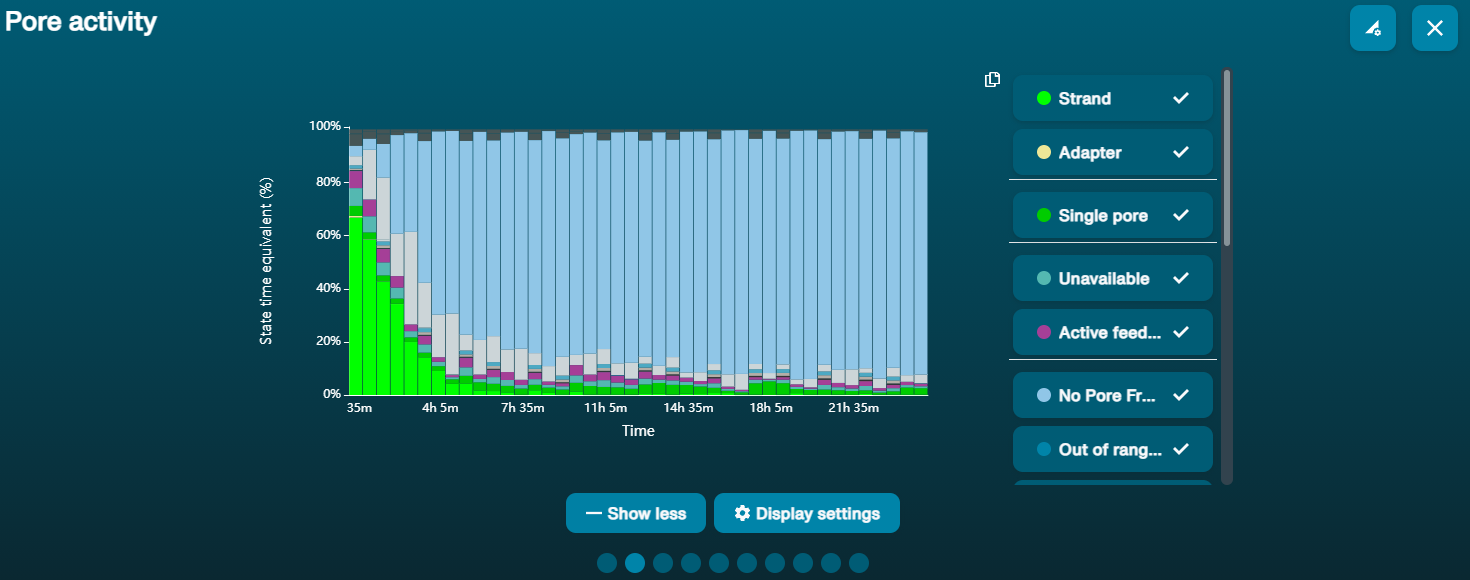 Conforme pasa el tiempo, el gráfico de actividad de poros de arriba muestra una proporción creciente de poros "no disponibles». | Hay contaminantes presentes en la muestra | Algunos contaminantes se eliminan de los poros mediante la función de desbloqueo incorporada en MinKNOW. Si funciona, el estado de los poros cambiará a "poro en secuenciación". Si la porción de poros inutilizables se mantiene elevada o aumenta: realizar un lavado con nucleasa con el kit Flow Cell Wash (EXP-WSH004). |
Gran proporción de poros inactivos
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Gran proporción de poros inactivos o no disponibles (se muestran en azul claro en el panel de canales y en el gráfico de actividad de poros. Los poros o membranas han sufrido daños irreversibles) | Se han introducido burbujas de aire en la celda de flujo | Si se introducen burbujas de aire durante el acondicionamiento de la celda de flujo y la carga de la biblioteca, se corre el riesgo de dañar irreversiblemente los poros.. La forma más eficaz de evitar que esto ocurra se muestra en el vídeo Cómo cargar celdas de flujo PromethION. |
| Gran proporción de poros inactivos o no disponibles | Ciertos compuestos copurificados con ADN | Ciertos compuestos, incluyen polisacáridos. Purificar con el kit PowerClean Pro de QIAGEN. |
| Gran proporción de poros inactivos o no disponibles | Hay contaminantes presentes en la muestra | Los efectos de los contaminantes se muestran en el documento técnico Contaminants. Probar con un método de extracción alternativo que no provoque el arrastre de contaminantes. |
Fluctuación de la temperatura
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| Fluctuación de la temperatura | La celda de flujo ha perdido contacto con el dispositivo | Comprobar que una almohadilla térmica cubra la placa metálica de la parte posterior de la celda de flujo. Reinsertar la celda de flujo y presionar hasta que las clavijas del conector estén firmemente en contacto con el dispositivo. Si el problema persiste, contacte con el servicio de Asistencia técnica. |
Error al intentar alcanzar la temperatura deseada
| Observaciones | Posibles causas | Comentarios y acciones recomendadas |
|---|---|---|
| MinKNOW muestra el mensaje «Error al intentar alcanzar la temperatura deseada» | El dispositivo se colocó en una ubicación con una temperatura ambiente inferior a la media o con escasa ventilación (lo que provoca el sobrecalientamiento de las celdas de flujo). | MinKNOW establece un intervalo de tiempo para que la celda de flujo alcance la temperatura fijada. Si se supera el tiempo establecido, aparecerá un mensaje de error, pero el experimento de secuenciación continuará. Secuenciar a una temperatura incorrecta suele provocar una disminución en el rendimiento y generar índices de calidad Q score menores. Corregir la ubicación del dispositivo, procurando que esté a temperatura ambiente y con buena ventilación; a continuación, reiniciar el proceso en MinKNOW. |
Last updated: 11/11/2026
Opciones de documento