多样本混样适应性采样 (MAS_9238_v114_revA_11Nov2026)


PromethION: Protocol
多样本混样适应性采样 V MAS_9238_v114_revA_11Nov2026
本指南介绍了人类基因组 DNA(gDNA)的文库制备及适应性采样测序流程,以提取的 gDNA 为起始材料,最终生成经碱基识别并按条形码拆分的 BAM 文件。
本实验指南:
- 使用从人类全血中提取的高分子量 gDNA
- 适用于在每张 PromethION 测序芯片上对 3 个经条形码标记的样本进行混样测序
- 主要用于生殖系分析
- 根据 BED 文件指定的目标区域进行富集。自定义基因集的 BED 文件可从数字化基因集设计工具(Digital Panel Designer)导出;即用型基因集的 BED 文件可直接下载
- 无需 PCR 扩增,可保留天然甲基化信息
- 与适用于 PromethION 24 和 PromethION 2 Integrated 设备的 R10.4.1 测序芯片兼容
仅供研究使用
FOR RESEARCH USE ONLY.
概览
本指南介绍了人类基因组 DNA(gDNA)的文库制备及适应性采样测序流程,以提取的 gDNA 为起始材料,最终生成经碱基识别并按条形码拆分的 BAM 文件。
本实验指南:
- 使用从人类全血中提取的高分子量 gDNA
- 适用于在每张 PromethION 测序芯片上对 3 个经条形码标记的样本进行混样测序
- 主要用于生殖系分析
- 根据 BED 文件指定的目标区域进行富集。自定义基因集的 BED 文件可从数字化基因集设计工具(Digital Panel Designer)导出;即用型基因集的 BED 文件可直接下载
- 无需 PCR 扩增,可保留天然甲基化信息
- 与适用于 PromethION 24 和 PromethION 2 Integrated 设备的 R10.4.1 测序芯片兼容
仅供研究使用
1. 实验方案概览
多样本混样适应性采样实验指南简介
本指南介绍了如何结合免扩增条形码试剂盒与 MinKNOW 的适应性采样靶向富集功能,完成文库制备和适应性采样测序。每张 PromethION 测序芯片支持 3 个样本的混样测序。多样本混样适应性采样方案包包含本指南所需的全部 Oxford Nanopore Technologies 试剂,提供 18 个样本和 72 个样本两种规格,内含免扩增条形码试剂盒及测序所需的配套产品,是实施本工作流程的标准配置。
您可以直接使用 Oxford Nanopore 提供的即用型数字化基因集(仅供科研使用),其配套的 BED 文件中已列明需要富集的目标区域;也可通过适应性采样数字化基因集设计工具(Digital Panel Designer)创建自定义基因集。创建方法详见适应性采样技术指南 - 数字化基因集设计工具。
本方案不涵盖数据分析。第 13 节“数据输出与分析”说明了分析时应使用的 BED 文件和工作流程。其中,遗传性癌症基因集使用 wf-hereditary-cancer,自定义生殖系基因集使用 wf-human-variation。
预期用途与测序表现
多样本混样适应性采样方案主要用于生殖系分析。此类分析通常只需目标区域达到中等测序深度,无需达到低频变异检测所要求的较高测序深度。
对于目标区域占基因组 0.1–5% 的基因集,预计每张芯片上的三个样本均可达到约 30× 的目标区域平均测序深度,且各样本约 90% 的目标碱基测序深度超过 20×。实际测序深度因自定义基因集的大小、基因组成和序列特征而异,也受芯片可用纳米孔数量、文库片段长度及三个样本混合比例的影响。
我们建议您在批量处理样本前,先开展预实验,确认测序深度能否满足您的分析需求。
2. 使用即用型数字化基因集
Oxford Nanopore 数字化基因集规格
即用型数字化基因集
| 项目 | 遗传性癌症 | 泛癌种 | 泛血液肿瘤 |
|---|---|---|---|
| 富集基因 | 258 个遗传性癌症风险相关基因 | 723 个癌症相关基因 | 144 个血液恶性肿瘤相关基因 |
| 经验证的适应性采样方案 | 多样本混样适应性采样 | 超快速单样本适应性采样 单样本适应性采样 | 单样本适应性采样 |
| 起始量† | 1 µg | 超快速单样本:1 µg 单样本:500 ng–1 µg* | 1 µg |
| 起始样本类型 | 血液 | 实体瘤组织 | 血液、骨髓 |
| 推荐提取试剂盒 | 使用 Qiagen Puregene 试剂盒从人类血液中提取基因组 DNA‡ | 1. QIAamp Fast DNA Tissue 试剂盒(Qiagen,51404):推荐用于超快速单样本适应性采样。 2. Puregene Tissue 试剂盒(Qiagen,158063) 3. MagAttract HMW DNA 试剂盒(Qiagen,67563) | 1. 使用 Qiagen Puregene 试剂盒从人类血液中提取基因组 DNA‡ 2. QIAamp DSP DNA Mini 试剂盒(Qiagen,61304) 3. GenFind V3 Genomic DNA Extraction 试剂盒(Beckman Coulter,C34880) |
| 质量控制(Femto Pulse) | 可使用 Femto Pulse 系统检测提取的 gDNA,查看机械打断前后的片段长度分布图谱。示例见“起始 DNA”一节。 | 可使用 Femto Pulse 系统检测提取的 gDNA,查看机械打断前后的片段长度分布图谱。示例见“DNA 质控”一节。 | 可使用 Femto Pulse 系统检测提取的 gDNA,查看机械打断前后的片段分布图谱。示例见“DNA 质控”一节。 |
| 机械打断条件(离心速度及时间) | 以约 3,381 × g 离心 3 次,每次 1 分钟,每两次离心之间将管倒置。 | 以约 3,381 × g 离心 2 次,每次 30 秒,两次离心之间将管倒置。 | 以约 4,868 × g 离心 2 次,每次 1 分钟,两次离心之间将管倒置。 |
| 参考基因组 | GRCh38_GIABv3 | GRCh38_GIABv3 | GCA_000001405.15_GRCh38_no_alt_analysis_set.fna |
| 富集用 BED 文件(下载链接见适应性采样页面) | ONT_AS_HCP_GRCh38_enrichment_v1.bed | ONT_AS_PanCancer_GRCh38_enrichment_v1.bed | ONT_AS_PanHaem_GRCh38_enrichment_v1.bed |
- DNA 起始量最低为 500 ng,但建议尽可能使用 1 µg,以提高纳米孔利用率。
†为提高纳米孔利用率,DNA 起始量最多可增加至 2 µg。
‡该提取方法经 Oxford Nanopore 调整优化,使用 Puregene Blood 试剂盒(Qiagen,158023),采用更温和的混匀方式,并将最终 DNA 重悬步骤的温度由 65°C 调整为 50°C。
3. 实验流程步骤概览
多样本混样适应性采样实验指南简介
实验准备
您将需要:
- 提取起始样本(全血、gDNA)。 您可以采用以下推荐方案:使用 Qiagen Puregene 试剂盒从人全血中提取基因组 DNA。
- 通过数字化基因集设计工具(Digital Panel Designer)设计自定义基因集并导出 BED 文件,或直接下载即用型基因集的 BED 文件,并下载相应的 FASTA 参考文件(见第 4 节)。
- 确保您已准备好测序试剂盒、正确的仪器以及第三方试剂。
- 下载数据收集和分析软件。
- 检查您的测序芯片上有足够的活性纳米孔,以确保测序良好运行。
样本制备、建库及测序
| 实验步骤 | 流程 | 时间 | 中止节点 |
|---|---|---|---|
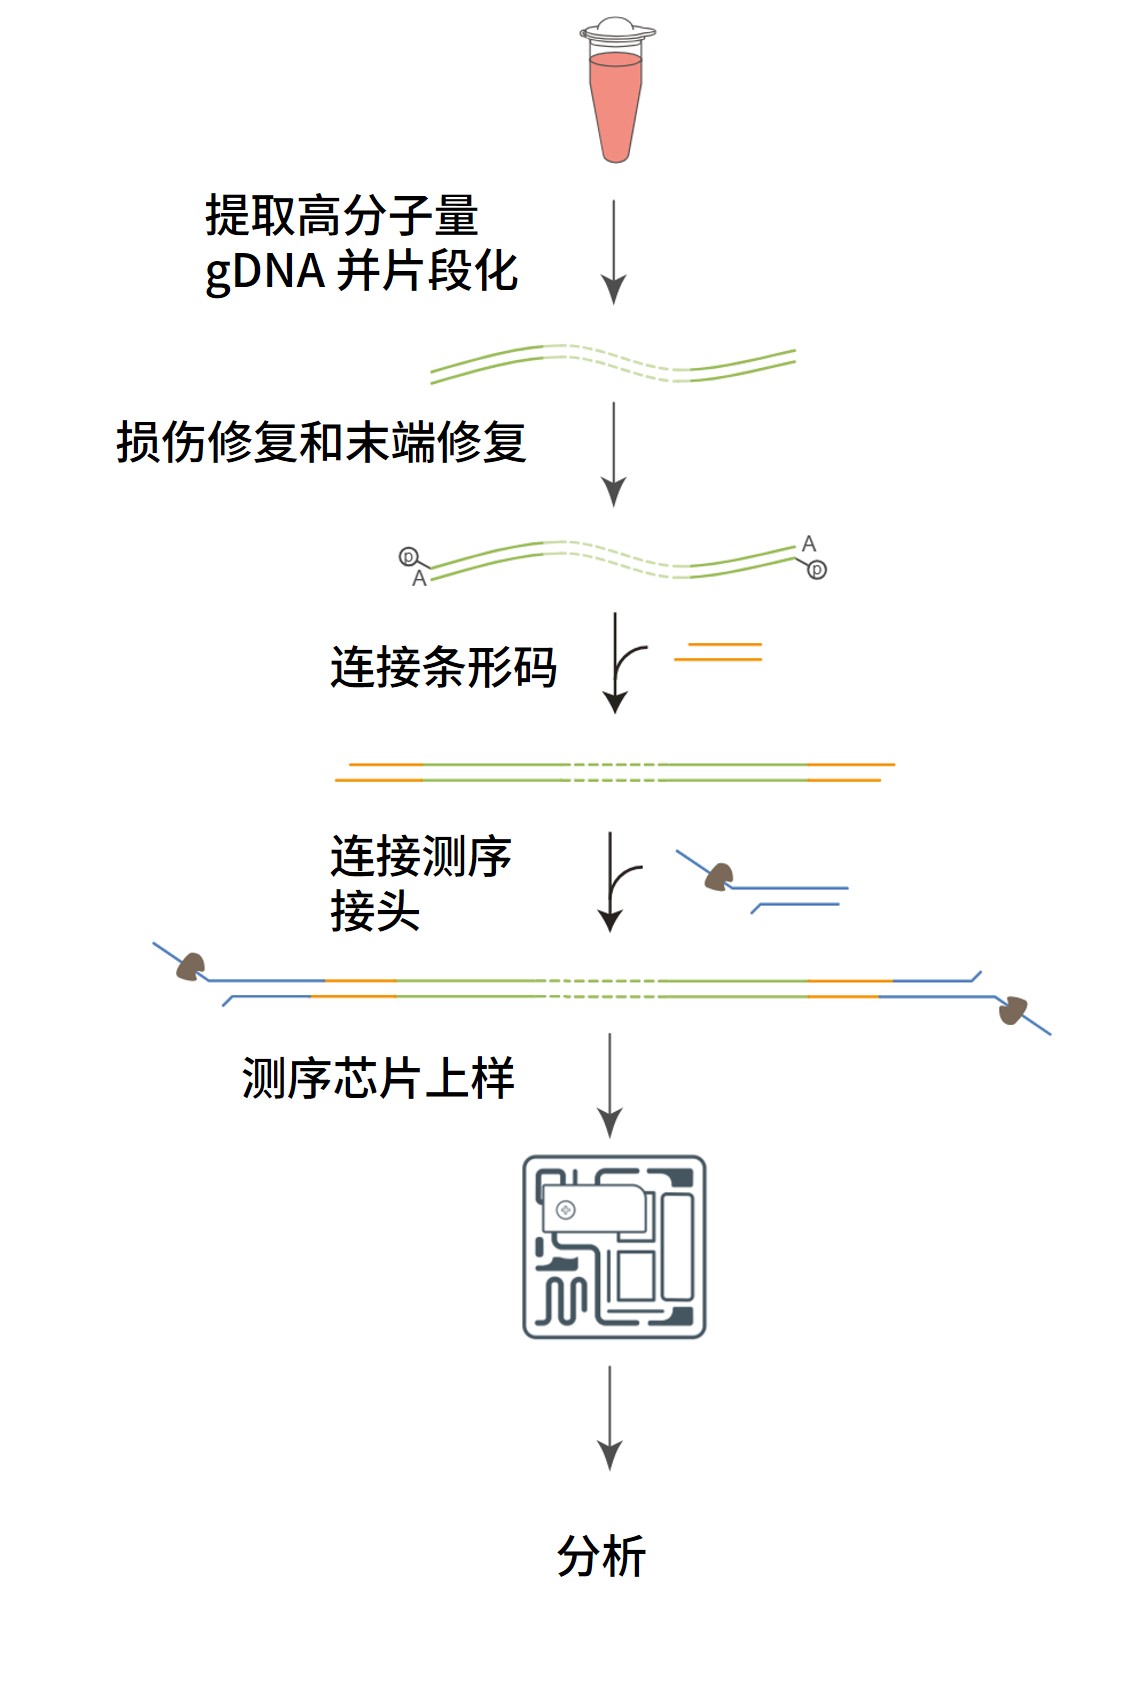
| 样本制备 | 从样本中提取 gDNA 并定量。将 gDNA 片段化并定量。 评估提取产物的长度、浓度和纯度。我们建议您在实验过程中进行各项质量评估,以确保实验顺利完成。 | 取决于采用的提取方法 机械打断约需 15 分钟 | 此时,可将提取的 gDNA 或片段化后的 gDNA 于 –20°C 保存,以备后续使用。 |
| DNA 损伤及末端修复 | 修复 DNA,并对 DNA 进行末端修复以便与接头连接 | 60 分钟 | 4°C 过夜 |
| 免扩增条形码连接 | 将免扩增条形码连接至 DNA 末端。 | 70 分钟 | 4°C 过夜 |
| 测序接头连接与纯化 | 将测序接头连接到 DNA 末端。 | 60 分钟 | 4°C 过夜 |
| 测序芯片的预处理及上样 | 对测序芯片进行预处理,然后将制备好的 DNA 文库加入测序芯片。 | 10 分钟 | |
| 测序 | 在测序设备上对文库进行测序。 | 72 小时 | |
| 数据分析 | 采用适合的 EPI2ME 工作流程。 |
实验方案适用性
本实验方案只适用于与以下产品搭配使用:
- 多样本混样适应性采样方案包(MAS18 或 MAS72)
- 免扩增条形码试剂盒-24 V14(SQK-NBD114.24)
- PromethION 测序芯片(FLO-PRO114M)
- PromethION 24 - PromethION 24/48 A-系列 - 设备及 IT 配置规格
- PromethION 2 Integrated - PromethION 2 Integrated - 设备及 IT 配置规格
4. Before getting started
Panel BED files
For a successful Adaptive Sampling run, MinKNOW needs two files: an enrichment BED file, which lists the regions to enrich for, and a reference FASTA file for the same genome build. Enrichment BED files can be created in the Digital Panel Designer, or you can start from one of our ready-to-use panels. Instructions for using the Digital Panel Designer, including the design checks and buffer settings, are given in the Adaptive Sampling technical guide.
The export produces three BED files and a summary report. The files are named by date and panel name, in the form:
YYYY-MM-DD_panel-name_enrichment.bed
Only the enrichment BED file is loaded into MinKNOW.
| File | Contents | Used in |
|---|---|---|
| *_enrichment.bed | Two rows per target, one for the plus strand and one for the minus strand, each with buffer at the 5′ end. | MinKNOW in the Adaptive Sampling BED field (section 12). |
| *_analysis.bed | One row per target, with no buffer. | Coverage and variant calling over the targets (section 13). |
| *_exons.bed | One row per exon of the MANE Select transcript of each gene, or of the Ensembl canonical transcript where there is none. | Exon-level coverage analysis (section 13). |
| summary.html | Panel statistics, design checks, the target table and a genome browser view of the targets and buffers. | Your record of the panel design. |
Reference genome
MinKNOW needs a reference FASTA file to align reads and make Adaptive Sampling decisions. The reference must be the same genome build that was selected in the Digital Panel Designer when the panel was exported. We recommend the following files:
| Panel | Build | Reference FASTA file for MinKNOW | Source |
|---|---|---|---|
| Custom panel | GRCh38 | GCA_ 000001405. 15_ GRCh38_ no_ alt_ analysis_ set. fna. gz | NCBI |
| Custom panel | GRCh37 | hg19. fa. gz | UCSC |
| Hereditary Cancer Panel | GRCh38 | GRCh38_ GIABv3_ no_ alt_ analysis_ set_ maskedGRC_ decoys_ MAP2K3_ KMT2C_ KCNJ18. fasta. gz | Genome in a Bottle |
The chromosome names in the reference FASTA file must match the BED file.
The BED files exported from the Digital Panel Designer use UCSC-style chromosome names (chr1, chr2, chrX), and all three recommended reference files use the same names.
If you use a different reference file that names chromosomes without the "chr" prefix (1, 2, X), MinKNOW will not find any of the targets. The run will then proceed without enrichment and will look like a low-coverage whole genome run.
For the Hereditary Cancer Panel, we recommend the Genome in a Bottle (GIAB) v3 GRCh38 reference, which was used to establish the performance of the panel. It is the GRCh38 no-alt analysis set with falsely duplicated regions of the assembly masked, so it uses the same coordinates, and the panel BED files exported from the Digital Panel Designer can be used with it unchanged.
The GRCh38 files above contain no alternate locus contigs. If a reference that includes alternate contigs is used instead, reads from regions with alternate haplotypes, such as the HLA genes, can be split between the primary assembly and the alternate contigs. The hg19 file contains a small number of haplotype contigs in the MHC region, and the same applies to panels with targets in that region.
If you use another reference file whose chromosome names differ from the BED files, rename the chromosomes in the BED files to match the reference. Do not rename the reference. We do not advise pre-indexing the reference before uploading it, as MinKNOW indexes it automatically at the start of the run. Reference requirements are described in more detail in the Adaptive Sampling technical guide.
5. 仪器及耗材
材料
- (用于文库制备)约 1 µg 经片段化处理的 gDNA
- 多样本混样适应性采样方案包(包含以下材料):
- 免扩增条形码测序试剂盒-24 V14(SQK-NBD114.24)
- 长片段缓冲液扩展包(EXP-LFB001)
- 适用于 72 样本方案包的短片段缓冲液扩展包(EXP-SFB001)
耗材
- PromethION 测序芯片(FLO-PRO114M)
- g-TUBE™(Covaris,520079)
- NEBNext FFPE修复混合液(NEB,M6630)
- NEBNext Ultra II 末端修复/ dA尾添加模块(NEB,E7546)
- NEB Blunt/TA 连接酶预混液(NEB,M0367)
- NEBNext®快速连接模块(NEB,E6056)
- 无核酸酶水(如 Thermo Scientific,AM9937)
- 新制备的 80% 乙醇(用无核酸酶水配制)
- Qubit dsDNA BR Assay(双链DNA宽范围检测)试剂盒(Invitrogen,Q32850)
- Qubit™ dsDNA HS Assay(双链 DNA 高灵敏度检测)试剂盒(Invitrogen,Q32851)
- Qubit™ 分析管(Invitrogen, Q32856)
- 1.5 ml Eppendorf DNA LoBind 离心管
- 0.2 ml 薄壁PCR管
- 基因组 DNA 165 kb 分析试剂盒(Agilent,FP-1002-0275)(可选)
仪器
- PromethION 测序设备
- PromethION 测序芯片遮光片
- 低速旋转式混匀仪(如 Hula 混匀仪)
- 适用于1.5ml Eppendorf 离心管的磁力架
- 迷你离心机
- 涡旋混匀仪
- 带加热盖的热循环仪
- 恒温加热仪
- 宽口移液枪头
- P1000 移液枪和枪头
- P200 移液枪和枪头
- P100 移液枪和枪头
- P20 移液枪和枪头
- P10 移液枪和枪头
- P2 移液枪和枪头
- 多通道移液枪和枪头
- 盛有冰的冰桶
- 计时器
- Qubit™ 荧光计(或用于质控检测的等效仪器)
可选仪器
- Femto Pulse 系统(Agilent Technologies)(或等效仪器)
Oxford Nanopore Technologies 多样本混样适应性采样方案包
多样本混样适应性采样方案包 包含本指南所需的全部 Oxford Nanopore Technologies 试剂,提供 18 个样本或 72 个样本两种规格。
方案包内含免扩增条形码试剂盒及测序所需的配套产品,是实施本工作流程的标准配置。
有关方案包及其中产品的详细信息,请参阅 Nanopore 商城中的以下产品页面:
- 多样本混样适应性采样方案包 18:适用于 18 个样本
- 多样本混样适应性采样方案包 72:适用于 72 个样本
上述清单列出了 DNA 样本打断及后续文库构建所需的材料、耗材和设备。
有关推荐 DNA 提取方法的耗材、设备和操作说明,请参阅实验指南:使用 Qiagen Puregene 试剂盒从人全血中提取基因组 DNA。
按照本方案制备文库,需准备以下起始材料:
- 约 1 µg 经片段化的 gDNA
起始 DNA
DNA 质控
选择符合质量和浓度要求的起始 DNA 至关重要。使用过少或过多的 DNA,或者质量较差的 DNA(如,高度碎片化、含有RNA或化学污染物)都会影响文库制备。
有关如何对 DNA 样品进行质控,请参考起始 DNA/RNA 质控实验指南。
化学污染物
不同的 DNA 提取方法可能导致纯化后的 DNA 中残留不同的化学污染物。这会影响文库的制备效率和测序质量。请参阅牛津纳米孔社区的污染物 页面了解更多信息。
Eppendorf 离心管的放置方向
在所有离心步骤中,请将离心管盖与管体的连接处朝外放置,以便快速定位沉淀。
取出离心管时应轻拿轻放,避免扰动沉淀。

第三方试剂
Oxford Nanopore Technologies 推荐您使用本实验指南中列出的所有第三方试剂,并已对其进行验证。我们尚未对其它替代试剂进行测试。
除非指南中另有说明,所有第三方试剂均建议按照制造商的说明进行使用前准备。
测序芯片质检
我们强烈建议您在保修期内、开始测序实验前,对测序芯片的活性纳米孔数进行质检。使用前,请从冷藏环境中取出测序芯片并拆除包装,在室温下回温 30 分钟。使用前,请从冰箱中取出测序芯片并拆除包装,在室温下回温 30 分钟。
请您按照测序芯片质检文档中的说明进行芯片质检。您可在质检过程中查看新测序芯片的活性纳米孔数。PromethION 测序芯片的质保标准为不低于 5000 个活性纳米孔。有关测序芯片的质保期、稳定性及储存条件等详细信息,请访问 Oxford Nanopore 商城。如有任何疑问,请联系 Oxford Nanopore 技术支持。
对于活性孔数少于 5000 且尚未投入测序的 PromethION 芯片,Oxford Nanopore Technologies 将予以更换,但芯片须自收货之日起始终按照 Oxford Nanopore Technologies 建议的条件储存,并在质检后两日内报告质检结果。
本试剂盒及实验指南中所使用的免扩增接头(NA) 不能与其它测序接头互换使用。
6. DNA 提取方案推荐
样本准备与 DNA 提取。
推荐使用以下方案从血液中提取基因组 DNA(gDNA):
提取出的 gDNA 可直接用于下一步的 gDNA 打断,也可在 4°C 条件下保存过夜。
Alternatively, your sample(s) can be stored at 4°C overnight or at –20°C for later use.
7. 使用 g-TUBE 管打断 DNA
材料
- 上一步提取的 gDNA:每个样本 >1 µg
耗材
- g-TUBE 管(Covaris,520079)
- 无核酸酶水(如 ThermoFisher,AM9937)
- Qubit dsDNA BR Assay(双链DNA宽范围检测)试剂盒(Invitrogen,Q32850)
- Qubit™ 分析管(ThermoFisher,Q32856)
- 1.5 ml Eppendorf DNA LoBind 离心管
- 基因组 DNA 165 kb 分析试剂盒(Agilent,FP-1002-0275)(可选)
仪器
- Eppendorf 5424 离心机(或等效器材)
- 迷你离心机
- Qubit™ 荧光计(或用于质控检测的等效仪器)
- 盛有冰的冰桶
- 计时器
- 宽口移液枪头
- P1000 移液枪和枪头
- P200 移液枪和枪头
- P100 移液枪和枪头
- P20 移液枪和枪头
- P10 移液枪和枪头
- P2 移液枪和枪头
可选仪器
- Femto Pulse 系统(Agilent Technologies)(或等效仪器)
使用无核酸酶水配制 DNA:
1.请确保已备好从样本中提取的 1 µg gDNA,并将其转移至 1.5 ml Eppendorf 管中。
2.如不足50 μl,请加入无核酸酶水补足。
3.使用宽口枪头充分吹打混匀。
4.使用迷你离心机瞬时离心。
将 50 µl 样品加入 g-TUBE 上端,旋紧管盖。
将样本管放入离心机,并按照制造商说明书的要求对离心机进行正确配平。
按以下条件对样本进行离心:
注意:离心转速可能因离心机型号而异。有关设备的详细信息,请参阅制造商的使用说明书。
1.以 3381 RCF(6000 rpm) 离心 60 秒。
2.目视检查,确认样品已完全从 g-TUBE 上腔流入下腔。如果样品尚未完全通过,请重复上述离心步骤,直至样品全部流入下腔。
3.将 g-TUBE 从离心机中取出,倒置后重新放回离心机,确认样品位于倒置后的上腔。
4.按上述离心条件,再次对 g-TUBE 进行离心: 3381 RCF(6000 rpm) 离心 60 秒。
5.目视检查,确认样品已完全从 g-TUBE 上腔流入下腔。如果样品尚未完全通过,请重复上述离心步骤,直至样品全部流入下腔。
再重复前一步骤两次,使样本在正、反两个方向通过 g-TUBE 的次数均达到 3 次。
待样品全部流入下腔后,旋下 g-TUBE 管身,保留装有样品的旋盖部分。
从旋盖中吸出样品,转移至洁净的 1.5 ml Eppendorf 离心管中。
使用 Qubit dsDNA BR Assay(双链 DNA 宽范围检测)试剂盒对样品进行定量。
请注意: g-TUBE 剪切后的 gDNA 量预计约为 1 µg 。预期 Qubit 测定浓度约为 18–20 ng/μl。
您可使用 Femto-Pulse(Agilent)评估打断后的 gDNA 长度。
剪切后的预期片段长度约为 7.5–8.5 kb。
所得 48 µL 打断后的 gDNA 可直接用于后续文库制备,或于 4°C 保存过夜。
8. DNA损伤及末端修复
材料
- 每个样本:上一步获得的打断后 gDNA,48 μL(1 μg)
耗材
- NEBNext FFPE DNA 修复混合液(NEB,M6630)
- NEBNext® Ultra II 末端修复/ dA尾添加模块(NEB,E7546)
- 无核酸酶水(如 Thermo Scientific,AM9937)
- 新制备的 80% 乙醇(用无核酸酶水配制)
- Qubit™ dsDNA BR Assay(双链 DNA 宽范围检测)试剂盒(Invitrogen,Q32850)
- Qubit™ 分析管(Invitrogen, Q32856)
- 0.2 ml 薄壁PCR管
- 1.5 ml Eppendorf DNA LoBind 离心管
仪器
- 迷你离心机
- 涡旋混匀仪
- 带加热盖的热循环仪
- 低速旋转式混匀仪(如 Hula 混匀仪)
- 适用于 1.5ml Eppendorf 离心管的磁性分离架
- Qubit™ 荧光计 (或用于质控检测的等效仪器)
- 盛有冰的冰桶
- P1000 移液枪和枪头
- P200 移液枪和枪头
- P100 移液枪和枪头
- P20 移液枪和枪头
- P10 移液枪和枪头
- P2 移液枪和枪头
根据生产厂家的说明准备NEBNext FFPE DNA 修复混合液和 NEBNext Ultra II 末端修复/ dA尾添加模块,并置于冰上。
为获得最优表现,NEB建议如下:
于冰上解冻所有试剂。
轻弹并/或翻转各管,确保各试剂充分混匀。
注意: 切勿涡旋振荡 FFPE DNA修复混合液或 Ultra II末端修复酶混合物。同一日内首次打开一管试剂前,请务必先将该管试剂瞬时离心。
Ultra II 末端修复缓冲液和 FFPE DNA 修复缓冲液内可能出现少量沉淀。待此两管液体回复至室温后,使用移液枪上下吹打数次,打散沉淀;然后涡旋振荡30秒,以确保沉淀充分溶解。
注意: 请务必涡旋振荡混匀缓冲液。FFPE DNA 修复缓冲液可能轻微泛黄,不影响使用。
请勿涡旋振荡 NEBNext FFPE DNA 修复混合液或 NEBNext Ultra II 末端修复酶混合物。
请务必涡旋振荡 NEBNext FFPE DNA 修复缓冲液及 NEBNext Ultra II 末端修复反应缓冲液,以充分混匀。
查看是否有残留沉淀。涡旋振荡至少 30 秒以溶解所有沉淀。
准备 DNA 样本:
1.确保每个样本均为 48 µl(约含 1 µg DNA),并分别置于洁净、独立的 0.2 ml 薄壁 PCR 管中。
2.吹打或轻弹离心管,充分混匀。使用迷你离心机瞬时离心。
在各 PCR 管中,混合以下试剂:
| 试剂 | 体积 |
|---|---|
| DNA 样本 | 48 µl |
| NEBNext FFPE DNA 修复缓冲液 | 3.5 µl |
| Ultra II 末端修复反应缓冲液 | 3.5 µl |
| Ultra II 末端修复酶混合物 | 3 µl |
| NEBNext FFPE DNA 修复混合液 | 2 µl |
| 总体积 | 60 µl |
充分吹打混匀管中试剂,再瞬时离心。
使用配备热盖的热循环仪,在 20°C 下孵育 5 分钟,再于 65°C 下孵育 5 分钟,随后在 4°C 保持。
将反应管从 PCR 仪中取出,并立即置于冰上。
此时,您可将每个样本的反应体系分别转移至一支洁净的 1.5 ml Eppendorf LoBind 管中,以便后续操作。
涡旋振荡以重悬 AMPure XP 磁珠(AXP)。
向每个末端修复反应中加入 1 倍体积(60 µL)重悬后的 AMPure XP 磁珠(AXP),轻弹离心管混匀。
将离心管置于低速旋转式混匀仪(如Hula混匀仪)上室温孵育10分钟。
用无核酸酶水新鲜配制 2 ml 80% 乙醇(足够 3 个样本使用)。
请注意:请确保配制足量的 80% 乙醇,以满足所有样本的处理需求。
将各样品瞬时离心,并于磁力架上静置 10 分钟,待磁珠与液相分离,且液相澄清无色。保持离心管在磁力架上不动,用移液枪吸去清液。
保持离心管在磁力架上不动,以 200 µl 新鲜制备的 80% 乙醇洗涤磁珠。小心不要扰动磁珠。用移液枪将乙醇吸走并弃掉。
重复上述步骤。
将离心管瞬时离心后置于磁力架上。用移液枪吸走残留的乙醇。让磁珠在空气中干燥约30秒,但不要干至表面开裂。
将装有样本的各离心管从磁力架上移开。将磁珠重悬于20 µl 无核酸酶水中。室温下孵育5分钟。
将离心管静置于磁力架上至少 1 分钟,直到磁珠和液相分离,且洗脱液澄清无色。
将每个样本的 20 μl 洗脱产物分别转移至一支新的 1.5 ml Eppendorf DNA LoBind 管中。
请注意:由于样本尚未添加条形码,请务必单独处理各样本。
取 1µl 洗脱样品,用Qubit定量。
我们建议对每张测序芯片对应的 3 个样本分别进行 3 次 Qubit 测定,即共进行 9 次测定,以获得更准确的定量结果,便于后续在添加条形码前将各样本调整至相同浓度。
请注意: 末端修复后,每个样本的预计回收量为 500–700 ng。
根据定量结果,以产量最低的样本为基准,对所有样本进行调整,具体步骤如下:
1.取16 µl 产量最低的样本,转移至一支新的 1.5 ml Eppendorf DNA LoBind 离心管中。
2.从其余各样本中分别移取与最低产量样本等质量的 DNA,并分别转移至洁净的 1.5 mL Eppendorf DNA LoBind 离心管中。
3.使用无核酸酶水将每个样本的体积补足至 16 μL。
完成末端修复的样本即可用于稍后的免扩增条形码连接步骤。
可选:此时,您也可以将样本置于 4℃ 保存过夜。
9. 免扩增条形码连接
材料
- 免扩增条形码(NB01-24)
- AMPure XP 磁珠(AXP)
- EDTA(EDTA)
- 短片段缓冲液(SFB)
耗材
- NEB Blunt/TA 连接酶预混液(NEB,M0367)
- 无核酸酶水(如 Thermo Scientific,AM9937)
- Qubit™ dsDNA HS Assay(双链 DNA 高灵敏度检测)试剂盒(Invitrogen,Q32851)
- Qubit™ 分析管(Invitrogen, Q32856)
- 1.5 ml Eppendorf DNA LoBind 离心管
仪器
- 迷你离心机
- 涡旋混匀仪
- 低速旋转式混匀仪(如 Hula 混匀仪)
- 适用于 1.5ml Eppendorf 离心管的磁性分离架
- 恒温加热仪
- Qubit™ 荧光计(或用于质控检测的等效仪器)
- 盛有冰的冰桶
- 多通道移液枪和枪头
- P1000 移液枪和枪头
- P200 移液枪和枪头
- P100 移液枪和枪头
- P20 移液枪和枪头
- P10 移液枪和枪头
- P2 移液枪和枪头
将 NEB Blunt/TA 连接酶预混液瞬时离心,吹打混匀后置于冰上。
于室温下解冻AMPure XP磁珠(AXP),并涡旋振荡混匀,置于室温。
于室温下解冻EDTA,并涡旋振荡混匀,然后瞬时离心,置于冰上。
于室温下解冻短片段缓冲液(SFB),并涡旋振荡混匀,然后置于冰上。
根据样本数目,于室温下解冻相应数目的免扩增条形码(NB01-24)。分别吹打混匀,瞬时离心后置于冰上。
条形码板孔仅限单次使用。使用前请确认所选孔密封完好;一旦刺穿或开启,不得再次使用。
为计划上样于同一张 PromethION 测序芯片的各样本选择不同的条形码。每张 PromethION 测序芯片最多支持 3 个经条形码标记的样本混样测序。
请注意: 每个样本使用一种条形码。
按下表所示顺序,向各装有等浓度样本的 1.5 mL Eppendorf 离心管中加入试剂。每加入一样试剂后,充分吹打混匀,再加入下一样试剂:
| 试剂 | 体积 |
|---|---|
| 经过末端修复的DNA | 16 µl |
| 免扩增条形码 (NB01-24) | 4 µl |
| Blunt/TA 连接酶预混液 | 20 µl |
| 总体积 | 40 µl |
轻轻吹打以充分混匀,并瞬时离心。
室温下孵育20分钟。
向每管样本中加入 4 µl EDTA,吹打混匀,然后瞬时离心。
在此步骤中添加EDTA的目的是终止反应。
于一支洁净的 1.5 mL Eppendorf DNA LoBind 离心管中,合并已连接条形码的各 DNA 样品(每组最多三个)。
涡旋振荡以重悬AMPure XP磁珠(AXP)。
向混合后的反应体系中加入 0.65× 体积的 AMPure XP 磁珠(AXP),吹打混匀。
合并 3 个样本(共 132 μL)时,需加入 86 μl AXP。
将离心管置于低速旋转式混匀仪(如 Hula 混匀仪)上室温孵育10分钟。
下一步纯化过程中,请使用短片段缓冲液(SFB)而非 80% 乙醇洗涤磁珠。
使用 80% 乙醇可能会导致实验结果欠佳。
将样品瞬时离心,再静置于磁力架上5分钟待磁珠和液相分离。保持离心管在磁力架上不动,直到洗脱液澄清无色,吸出上清。
加入 500 µL 短片段缓冲液(SFB)洗涤磁珠。轻弹离心管,重悬磁珠;瞬时离心后,将样品重新置于磁力架上,直至磁珠完全吸附、液相澄清。随后用移液枪吸出缓冲液并弃去。
重复上述步骤。
将离心管瞬时离心后置于磁力架上。用移液枪吸走残留的缓冲液。
将离心管从磁力架上移开。将磁珠重悬于 32 µl 的无核酸酶水中,轻弹离心管混匀。
37℃ 下孵育 10 分钟。请每两分钟轻弹离心管 10 秒以搅动样本,促进 DNA 洗脱。
将离心管静置于磁力架上,直到磁珠和液相分离,且洗脱液澄清无色。
将此 32 µl 洗脱液转移至一支新的 1.5ml Eppendorf DNA LoBind 管中。
取1µl洗脱样品,用Qubit荧光计定量。
请注意: 添加免扩增条形码后,每个样本的预计回收量为 600–800 ng。
连有条形码的DNA样本将用于稍后的接头连接及纯化步骤。如需要,您也可以此时将样品置于4℃储存过夜。
10. 接头连接及纯化
材料
- 长片段缓冲液(LFB)
- 洗脱缓冲液(EB)
- 免扩增接头(NA)
- AMPure XP 磁珠(AXP)
耗材
- NEBNext®快速连接模块(NEB,E6056)
- Qubit™ dsDNA HS Assay(双链 DNA 高灵敏度检测)试剂盒(Invitrogen,Q32851)
- Qubit™ 分析管(Invitrogen, Q32856)
- 1.5 ml Eppendorf DNA LoBind 离心管
仪器
- 迷你离心机
- 涡旋混匀仪
- 低速旋转式混匀仪(如 Hula 混匀仪)
- 适用于 1.5ml Eppendorf 离心管的磁性分离架
- 恒温加热仪
- 盛有冰的冰桶
- P1000 移液枪和枪头
- P200 移液枪和枪头
- P100 移液枪和枪头
- P20 移液枪和枪头
- P10 移液枪和枪头
- Qubit™ 荧光计(或用于质控检测的等效仪器)
本试剂盒及实验指南中所使用的免扩增接头(NA) 不能与其它测序接头互换使用。
测序芯片质检
我们建议在开始文库制备之前,对测序芯片的活性纳米孔数量进行质检,以确保其足够支持实验的顺利进行。
使用前,请从冰箱中取出测序芯片并拆除包装,在室温下回温 30 分钟。
潮湿环境下的测序芯片上可能会形成冷凝水。因此,请检查测序芯片顶部和底部的金色连接器引脚处是否有水凝结。如有,请使用无纤维布擦干。请确保测序芯片底部有热垫(深灰色)覆盖。
详情请参阅 MinKNOW 实验指南中的 测序芯片质检说明。
根据生产厂家的说明准备NEBNext 快速连接反应模块,并置于冰上:
1.于室温下解冻 NEBNext 快速连接反应缓冲液;
2.瞬时离心各试剂管5秒;
3.每次吸取全部反应液进行吹打混匀,共 10 次,确保试剂充分混匀。
4.将快速T4 DNA连接酶置于冰上。请 勿 涡旋振荡快速 T4 DNA 连接酶。
NEBNext快速连接反应缓冲液(5x)内可能存在少量沉淀。请待该缓冲液回复至室温后,吹打数次打散沉淀,再涡旋振荡数秒以充分混匀。
请勿涡旋振荡快速T4 DNA连接酶。
将免扩增接头(NA)瞬时离心后吹打混匀,然后置于冰上。
将洗脱缓冲液(EB)于室温下解冻,涡旋振荡混匀后,再瞬时离心,置于冰上。
在室温下解冻长片段缓冲液(LFB),涡旋振荡混合后,置于冰上。
在一支 1.5ml Eppendorf LoBind 离心管内,将所有试剂按以下顺序混合:
| 试剂 | 体积 |
|---|---|
| 三样品混合后的带条码文库 | 30 µl |
| 免扩增接头(NA) | 5 µl |
| NEBNext 快速连接反应缓冲液(5X) | 10 µl |
| 快速 T4 DNA 连接酶 | 5 µl |
| 总体积 | 50 µl |
轻轻吹打以充分混匀,并瞬时离心。
室温下孵育20分钟。
以下纯化步骤中使用长片段缓冲液(LFB)而非 80% 乙醇洗涤磁珠。使用乙醇将对测序反应产生不利影响。
涡旋振荡以重悬AMPure XP磁珠。
将 0.5× 体积(25 µL)经过重悬的 AMPure XP(AXP)磁珠加入反应体系,吹打混匀。
将离心管置于低速旋转式混匀仪(如 Hula 混匀仪)上室温孵育 10 分钟。
将样品瞬时离心,并静置于磁力架上待磁珠和液相分离。保持离心管在磁力架上不动,用移液枪吸去清液。
用 250 μl 的长片段缓冲液(LFB)洗涤磁珠。轻弹离心管将磁珠混匀后,将离心管瞬时离心,再放回磁力架,静置不少于 5 分钟,待磁珠和液相分离。保持离心管在磁力架上不动,用移液枪吸出清液并丢弃。
请注意:吸取上清液时请谨慎操作,由于缓冲液黏度较高,可能会将磁珠一同吸出。
重复上述步骤。
将离心管瞬时离心后置于磁力架上。用移液枪吸走残留的上清液。让磁珠在空气中干燥约30秒,但不要干至表面开裂。
将离心管从磁力架上移开。将磁珠重悬于 35 µl 洗脱缓冲液中(EB)。
瞬时离心,然后在37℃下孵育10分钟。请每两分钟轻弹离心管10秒以搅动样本,促进DNA洗脱。
将离心管静置于磁力架上至少一分钟,直到磁珠和液相分离,且洗脱液澄清无色。
将此 35 µl 含有DNA文库的洗脱液转移至一支新的 1.5ml Eppendorf DNA LoBind 管中。
将磁珠丢弃。
取 1 µl 洗脱样品,用 Qubit 荧光计定量。
请注意:连接接头后,每个样本的预计回收量为 300–500 ng。
请注意:如果上样至测序芯片的 DNA 少于 250 ng,可能会导致孔利用率下降,从而无法达到目标数据产出。
构建好的文库即可用于测序芯片上样。在上样前,请将文库置于冰上或4℃条件下保存。
对于本方法,我们建议在建库完成后尽快将文库上样至测序芯片。
11. PromethION 测序芯片的预处理及上样
材料
- 测序芯片冲洗液(FCF)
- 测序芯片系绳(FCT)
- 文库颗粒(LIB)
- 测序缓冲液(SB)
耗材
- PromethION 测序芯片(FLO-PRO114M)
- 1.5 ml Eppendorf DNA LoBind 离心管
仪器
- PromethION 测序设备
- PromethION 测序芯片遮光片
- 涡旋混匀仪
- 迷你离心机
- 盛有冰的冰桶
- P1000 移液枪和枪头
- P200 移液枪和枪头
- P100 移液枪和枪头
- P20 移液枪和枪头
本试剂盒仅兼容R10.4.1测序芯片(FLO-PRO114M)。
将芯片从冰箱中取出后,请将其置于室温环境孵育 30 分钟再插入PromethION测序仪。
潮湿环境下的测序芯片上可能会形成冷凝水。因此,请检查测序芯片顶部和底部的金色连接器引脚处是否有水凝结。如有,请使用无纤维布擦干。请确保测序芯片底部有热垫(黑色)覆盖。
于室温下解冻测序缓冲液(SB)、文库颗粒(LIB)、测序芯片系绳(FCT)和一管测序芯片冲洗液(FCF)。完全解冻后,涡旋振荡混匀,然后瞬时离心并置于冰上。
根据待冲洗的测序芯片数量,选择合适规格的离心管,配制测序芯片预处理液。配制完成后,短暂涡旋振荡,充分混匀。
| 试剂 | 体积(每张芯片) |
|---|---|
| 测序芯片冲洗液 (FCF) | 1170 µl |
| 测序芯片系绳 (FCT) | 30 µl |
| 总体积 | 1200 µl |
将待运行的测序芯片插入 PromethION 上相应插槽的对接端口。
请确保芯片底部的深灰色加热垫无撕裂或变形。
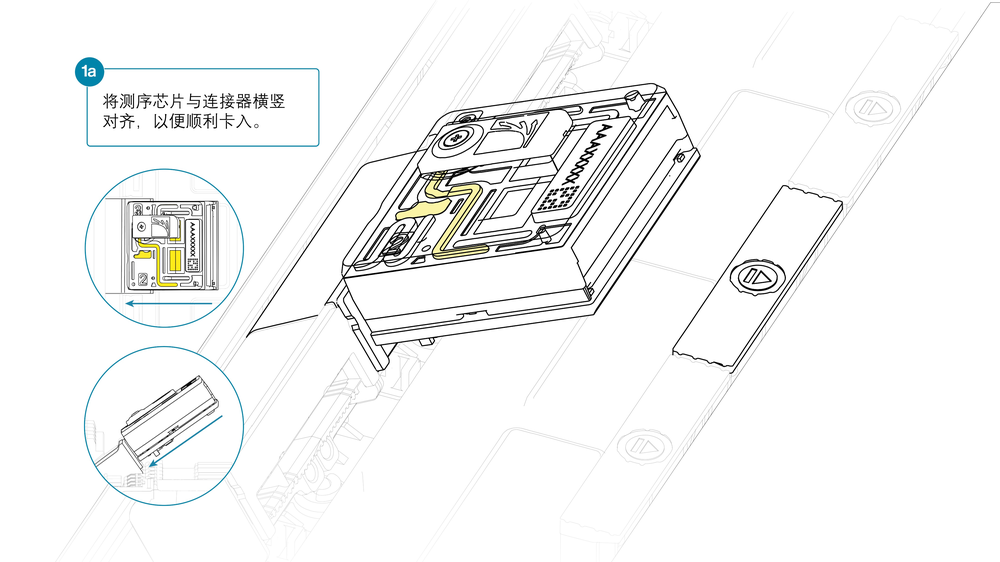
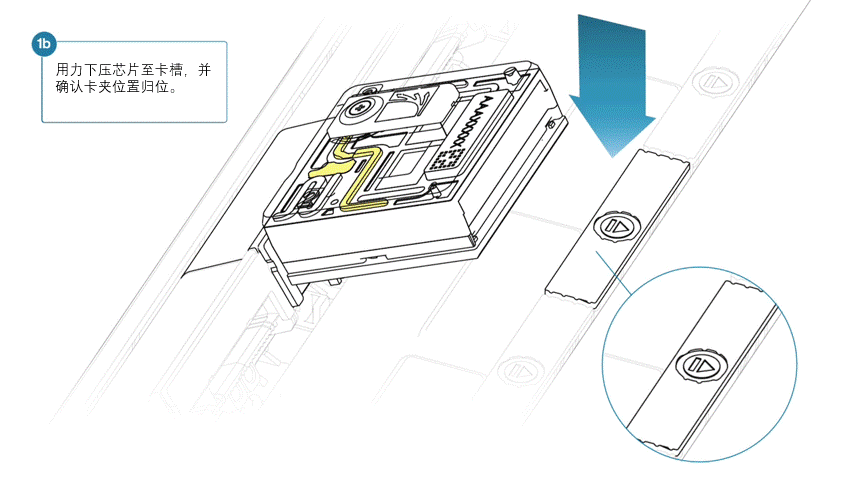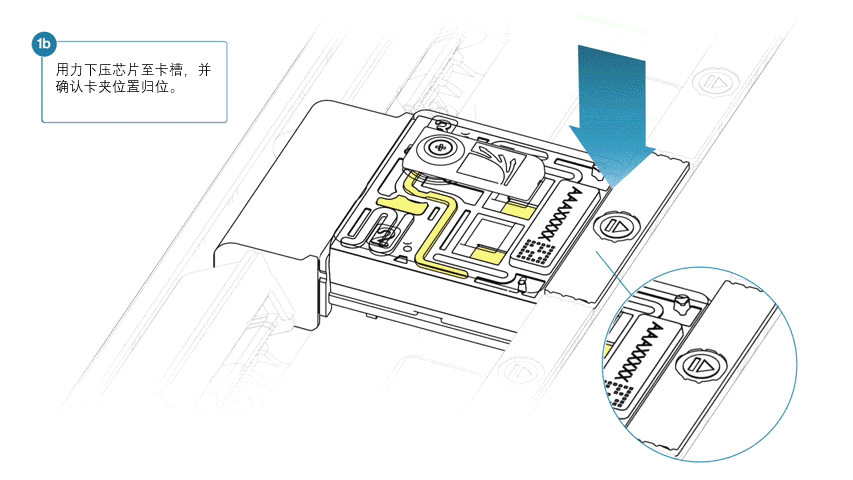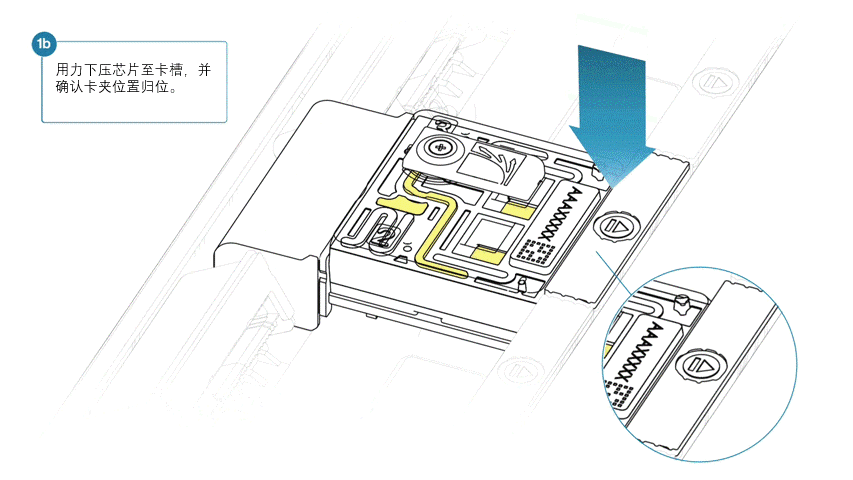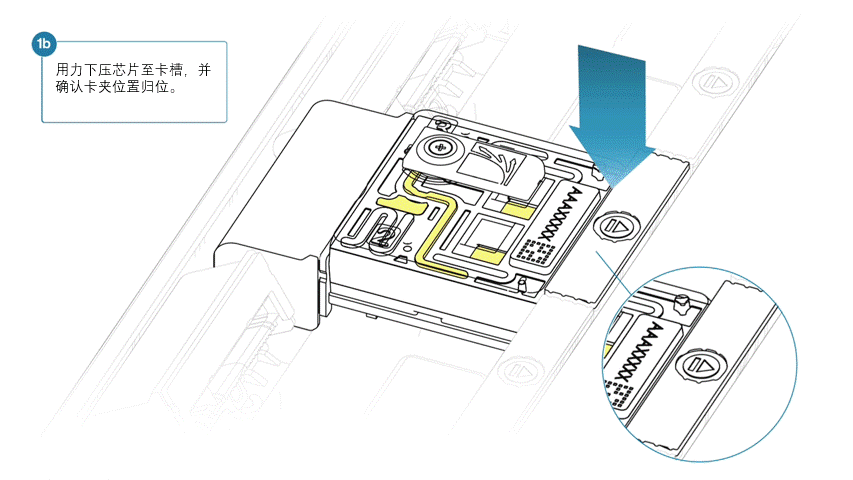
对 PromethION 24:
1.将测序芯片与连接器横竖对齐,以便顺利卡入。
2.用力下压芯片至卡槽,并确认卡夹位置归位。
对 PromethION 2 Integrated:
将测序芯片平放在金属板上。.
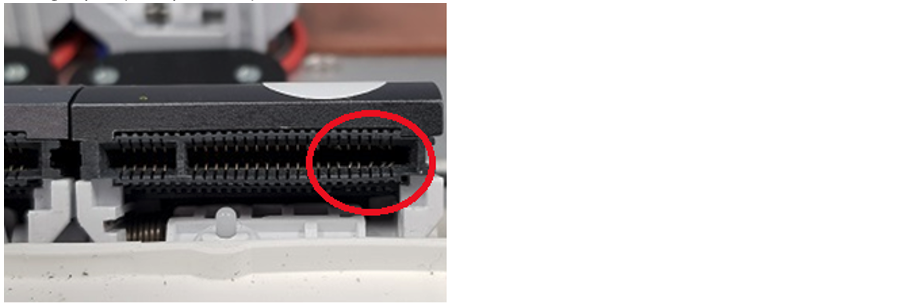
将测序芯片推入对接端口,直至金色引脚或绿色电路板不可见。
用力下压芯片,直到听到咔哒声。

如插入配置测试芯片的角度出现偏差,可能会损坏PromethION上的引脚并影响测序结果。如您发现 PromethION测序仪芯片位置上的引脚损坏,请通过电子邮件(support@nanoporetech.com)或微信公众号在线支持(NanoporeSupport)联系我们的技术支持团队。
请在文库上样前完成测序芯片质检,评估可用的活性纳米孔数量。
若该测序芯片此前已完成质检,则可跳过此步骤。
详细操作说明请参阅 MinKNOW 实验指南中的测序芯片质检说明部分。
顺时针滑动加液孔孔盖,将其打开。
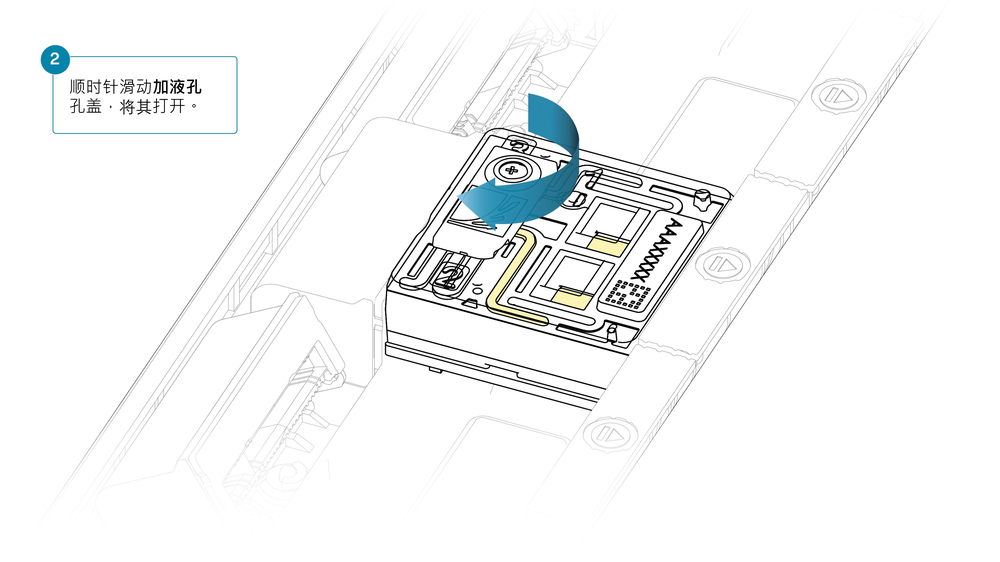
从测序芯片中反旋排出缓冲液。请勿吸出超过 20-30µl 的缓冲液,并确保芯片上的纳米孔阵列一直有缓冲液覆盖。将气泡引入阵列会对纳米孔造成不可逆转地损害。
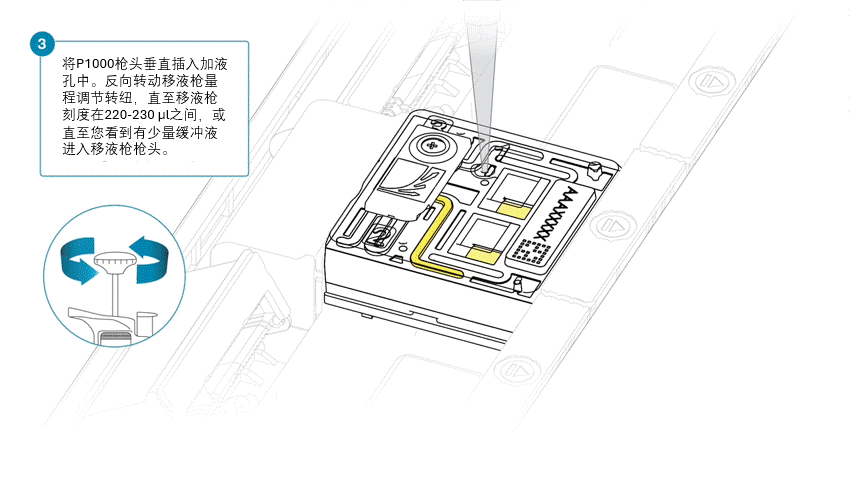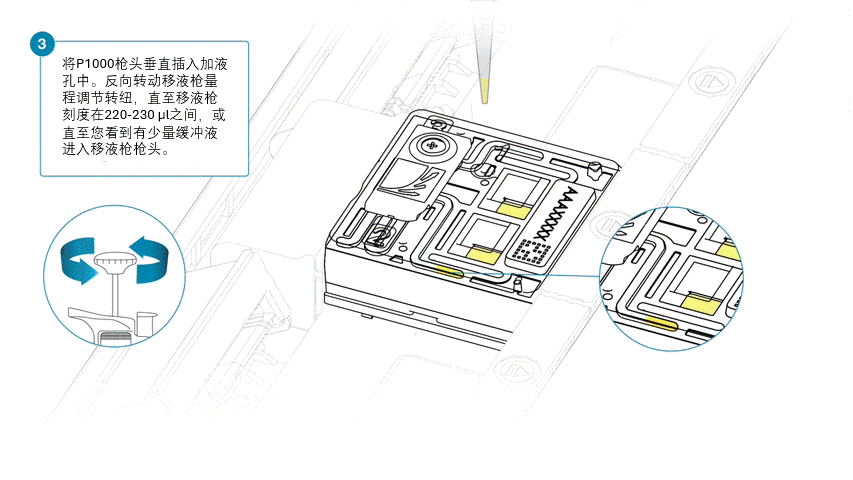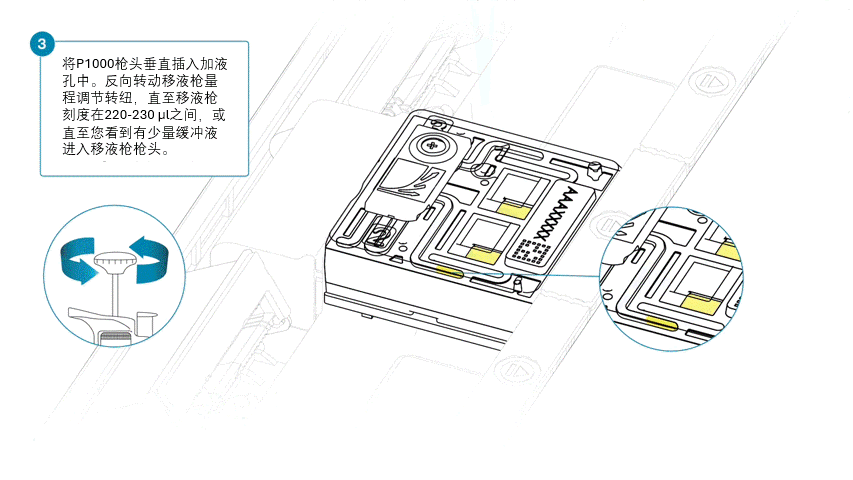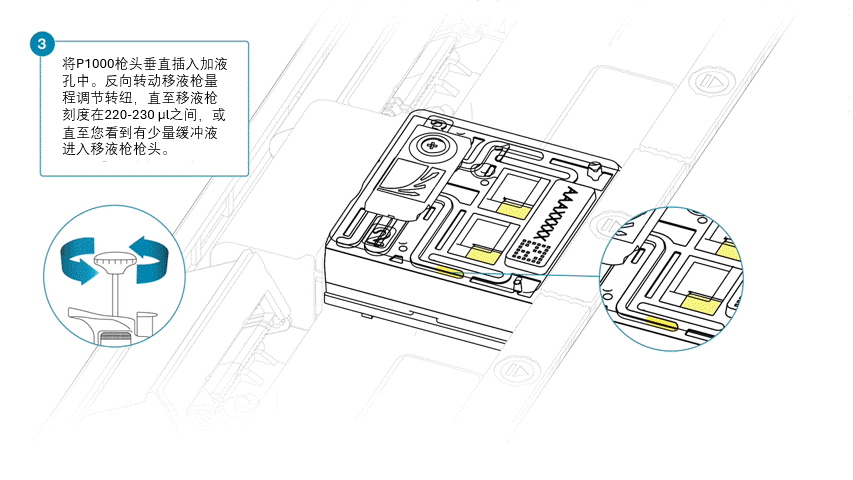
在加液孔打开的状态下,按下述步骤吸取少量液体,同时避免引入气泡:
1.将P1000移液枪转至200µl刻度。
2.将枪头垂直插入加液孔中。
3.反向转动移液枪量程调节转纽,直至移液枪刻度在 220-230 µl 之间,或直至您看到有少量缓冲液进入移液枪枪头。
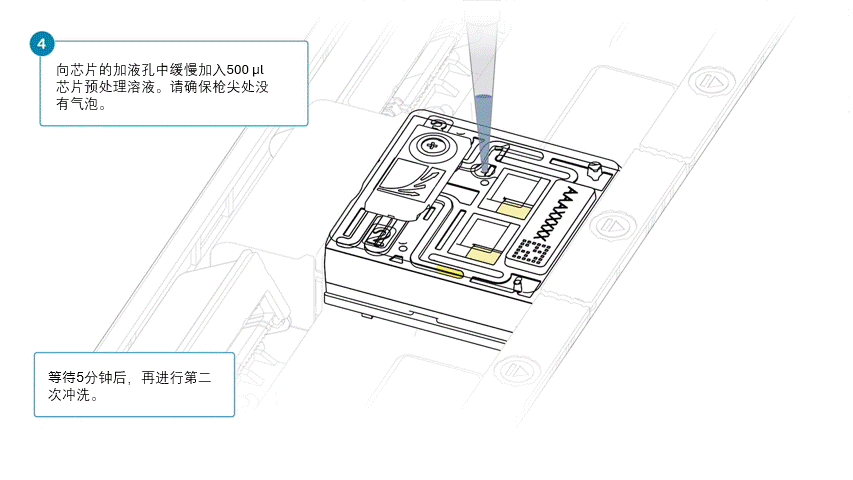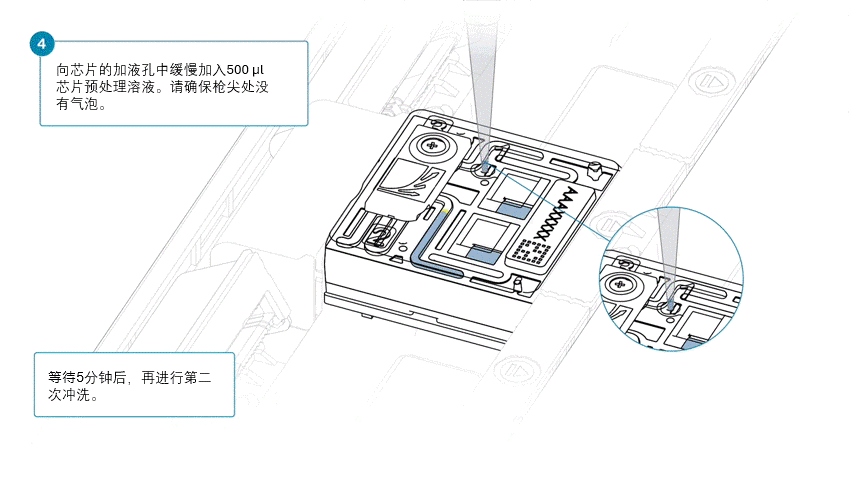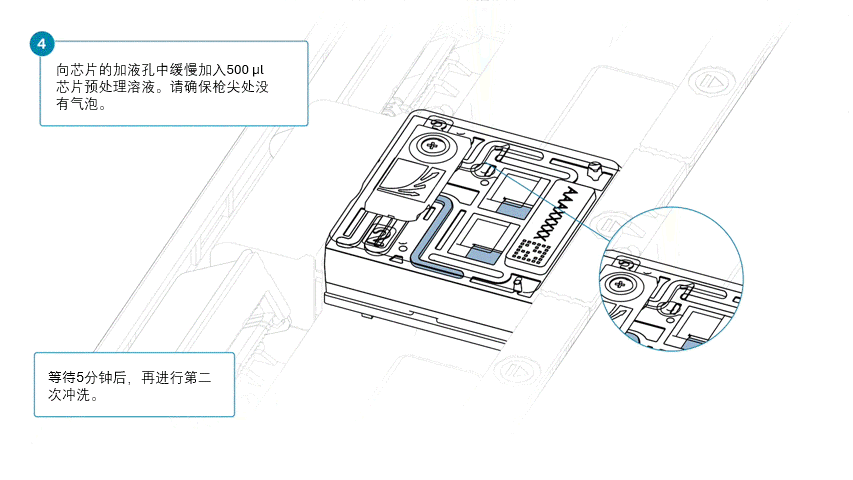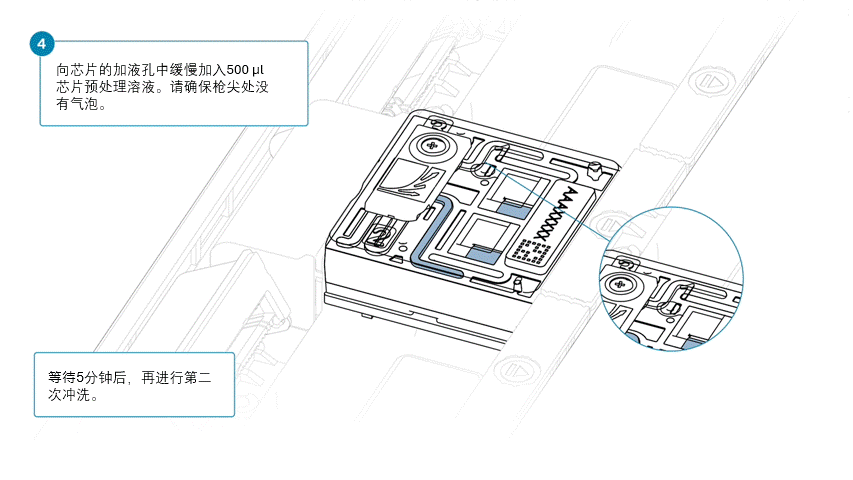
使用 P1000 移液枪向芯片的加液孔中加入 500 µl 芯片预处理溶液。加入过程中,请避免引入气泡。等待 5 分钟,与此同时,您可按以下步骤准备上样文库。
将含有文库颗粒的 LIB 管用移液枪吹打混匀。
LIB 管内的文库颗粒分散于悬浮液中。由于颗粒沉降速度非常快,因此请在混匀颗粒后立即使用。
对于大多数测序实验,我们建议您使用文库颗粒(LIB)。
在一支新的 1.5ml Eppendorf DNA LoBind 离心管内,将所有试剂按以下顺序混合:
| 试剂 | 每张测序芯片的上样体积 |
|---|---|
| 测序缓冲液 (SB) | 100 µl |
| 文库颗粒 (LIB),使用前充分混匀 | 68 µl |
| DNA 文库 | 32 µl |
| 总体积 | 200 µl |
请注意: 此处增大了文库的上样量,以增强纳米孔阵列的覆盖度。
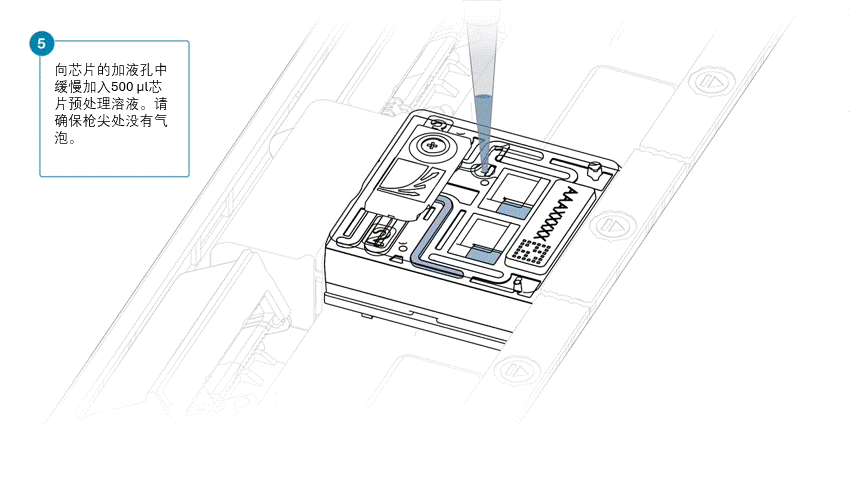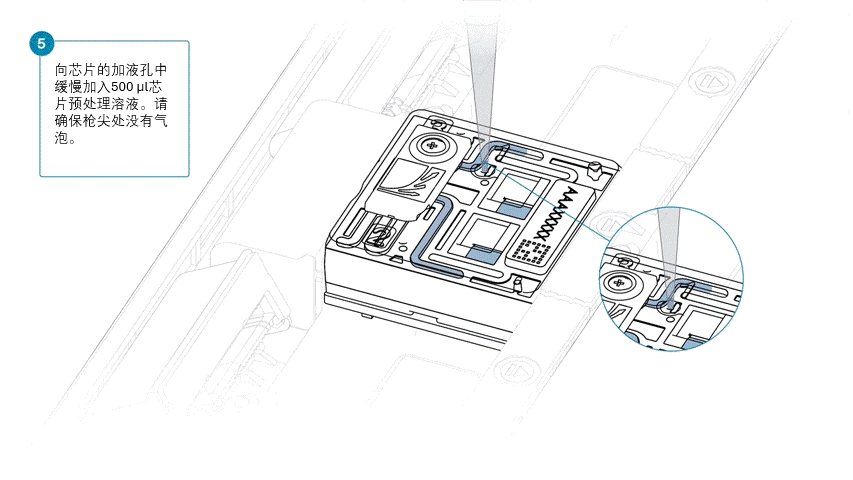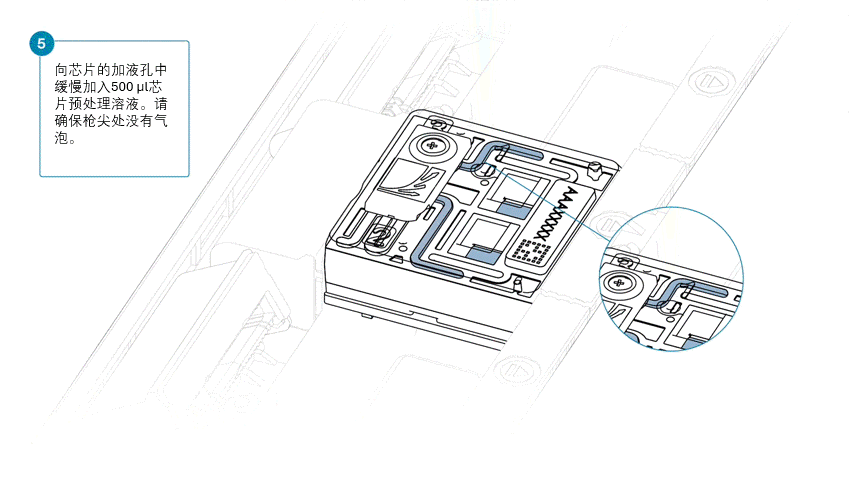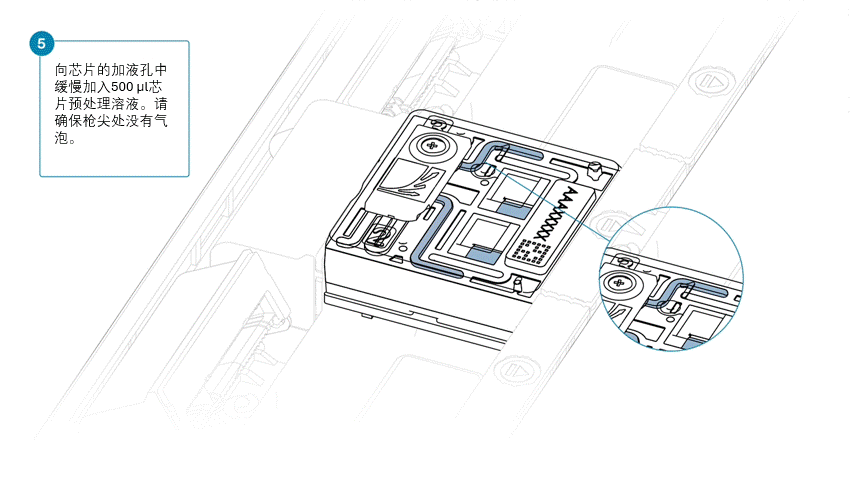
缓慢向芯片的加液口中加入 500 µl 预处理液,完成芯片的预处理。
临上样前,用移液枪轻轻吹打混匀制备好的文库。
使用 P1000 移液枪向加液孔中加入 200 µl 文库。
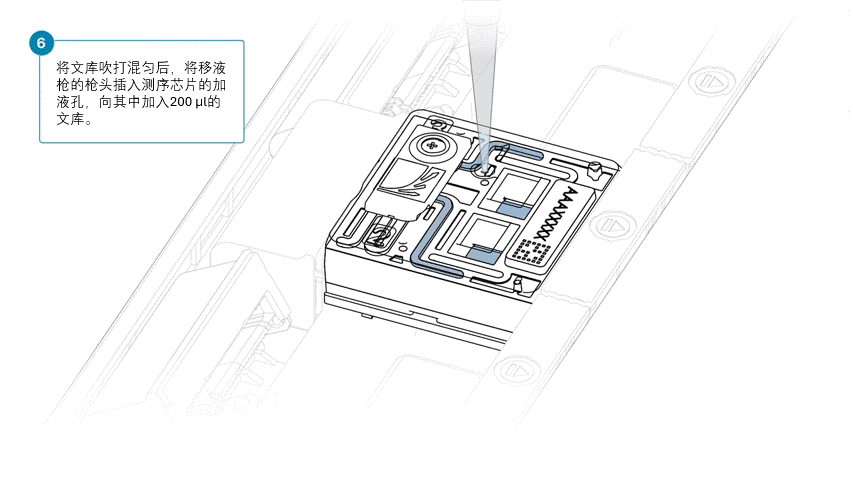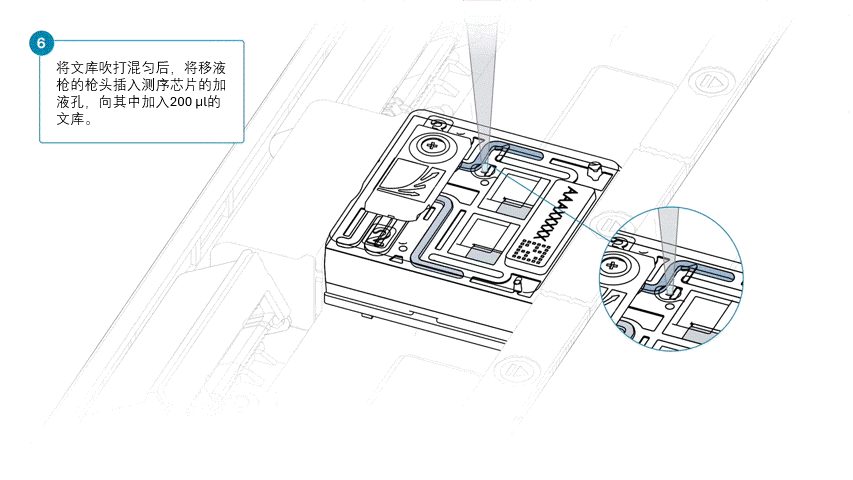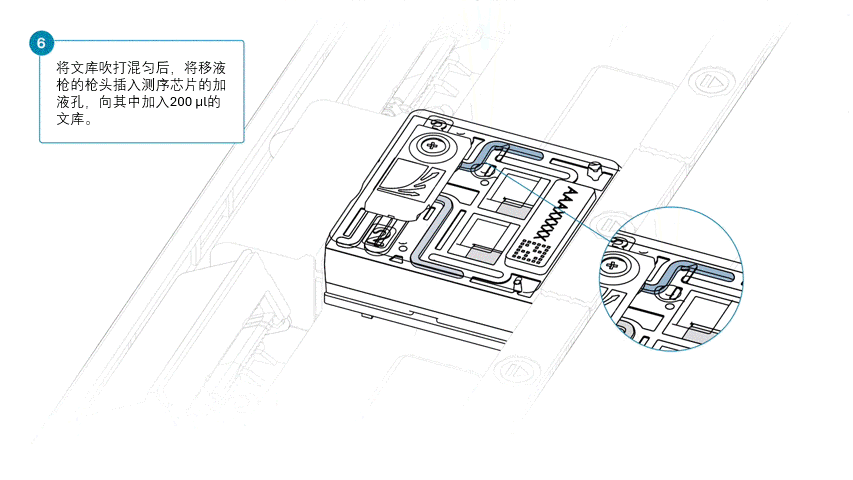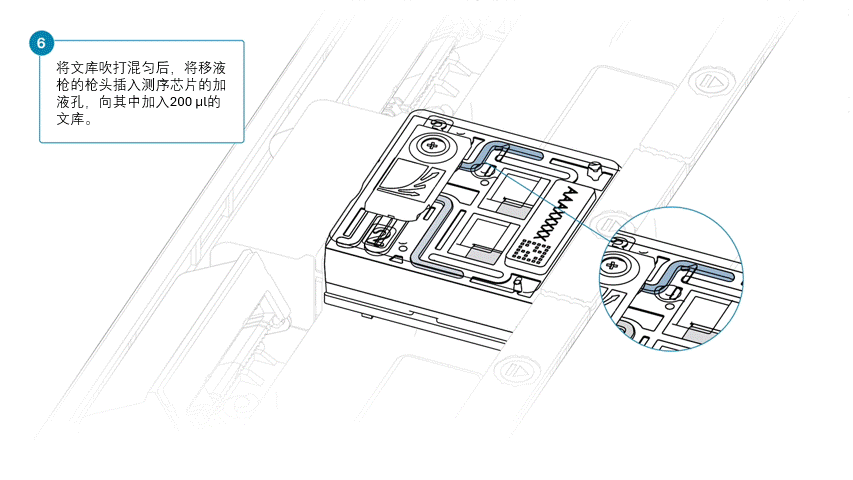
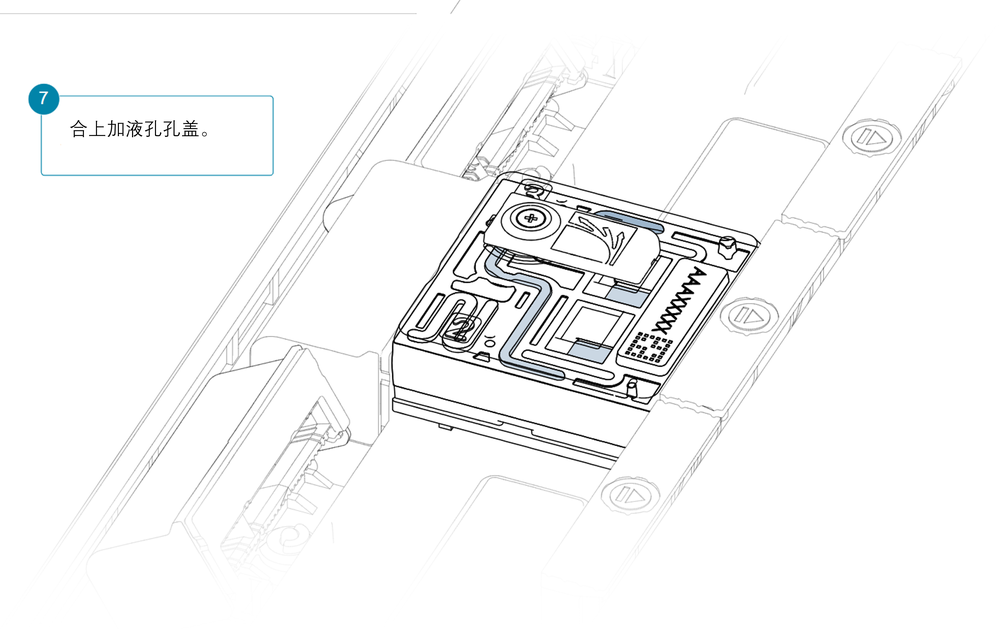
合上加液孔孔盖。
为获得最佳测序产出,在文库样本上样后,请立即在测序芯片上安装遮光片。
我们建议在文库加样至测序芯片后(包括芯片清洗并重新加样时),将遮光片保留在测序芯片上。一旦文库从测序芯片中吸出,即可取下遮光片。
如遮光片不在测序芯片上,请您按照以下步骤安装:
1.将遮光片的中空部分(空槽)与测序芯片的加液孔孔盖对齐。确保遮光片的前沿位于测序芯片ID的上方。
2.用力下压芯片至卡槽,并确认卡夹位置归位。
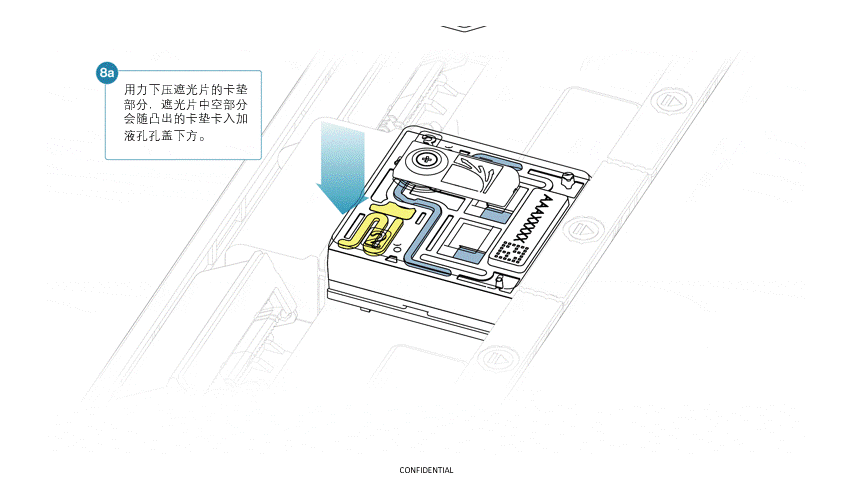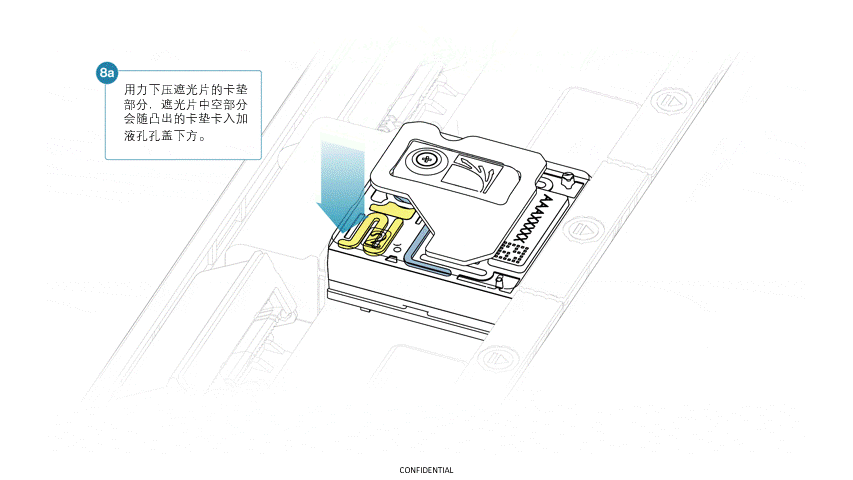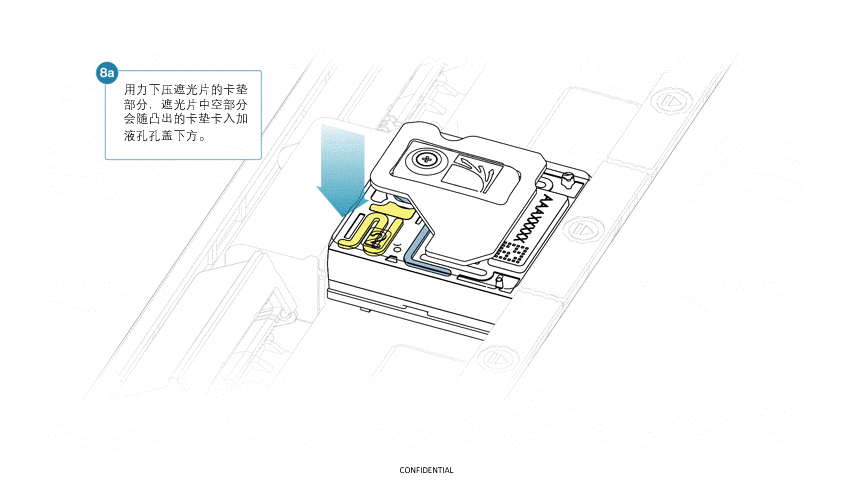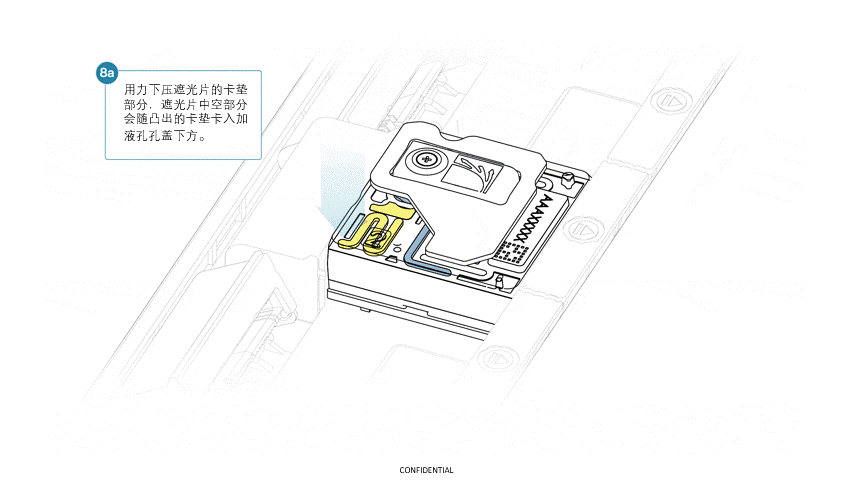
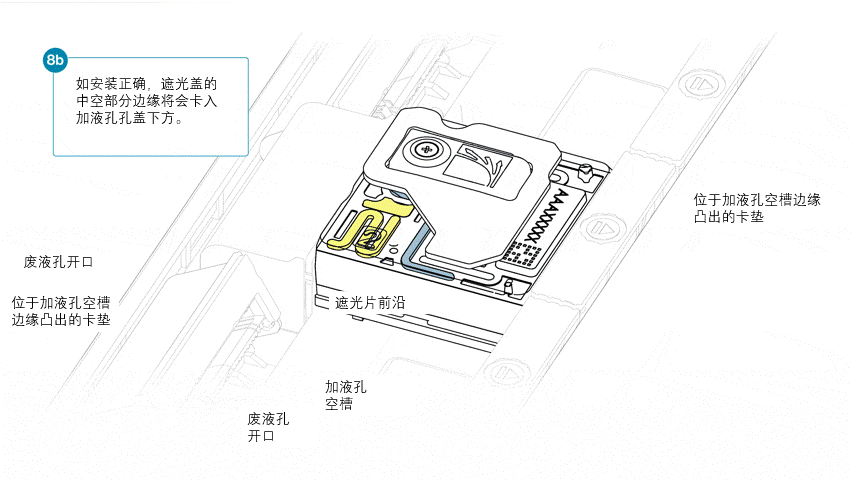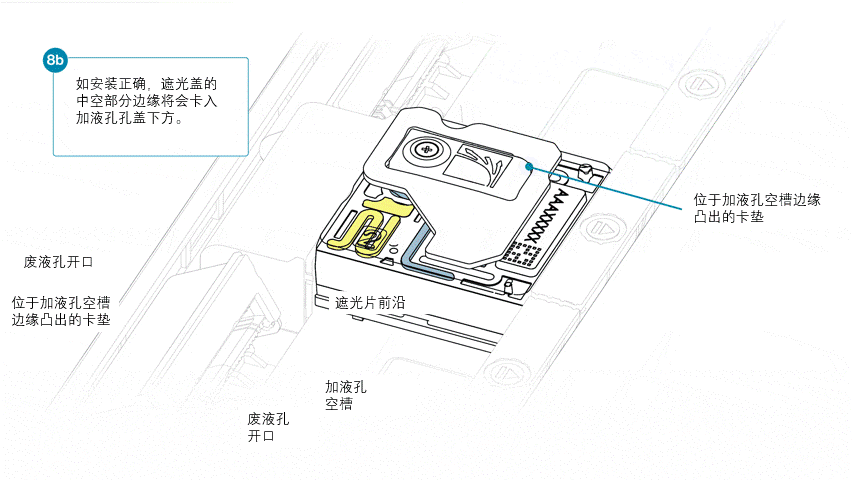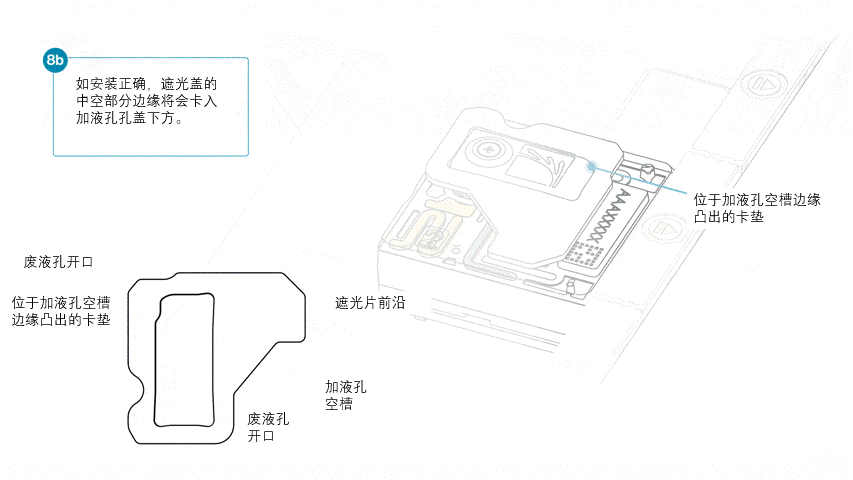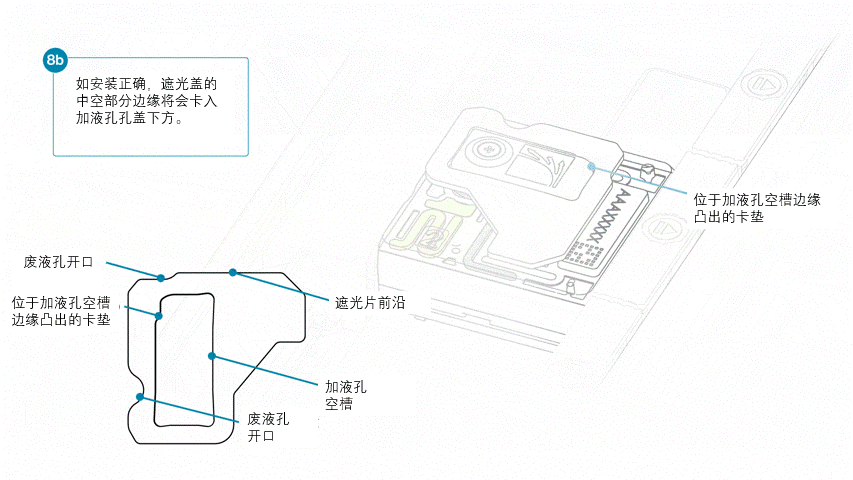
准备就绪后,合上PromethION设备上盖。
请在为PromethION芯片上样后,等待10分钟再启动实验,以提高芯片产出。
12. 数据采集和碱基识别
如何开始测序
MinKNOW软件负责仪器控制,数据采集和实时碱基识别。
请参阅以下链接,获取有关设备设置和测序运行的详细操作说明:
- PromethION 24:Starting a sequencing run with PromethION 24(使用 PromethION 24 进行测序)
- PromethION 2 Integrated:Starting a sequencing run on PromethION 2 Integrated(使用 PromethION 2 Integrated 进行测序)
两款设备均采用相同的测序运行设置。
开始前的准备
启动测序前,请确认:
- 设备中已保存所需的 FASTA 参考文件(见第 4 节“参考基因组”)和富集用 BED 文件。
- 设备有足够的存储空间,可保存每张芯片产出的数据。
- 已根据下文说明,决定是否启用“仅对目标序列进行碱基识别”选项。
实时碱基识别与“仅对目标序列进行碱基识别”
建议您使用高精准(HAC)模型进行实时碱基识别,并以 BAM 格式输出。在 MinKNOW 中,您可通过“仅对目标序列进行碱基识别”选项选择碱基识别的范围;是否启用该选项,取决于您是否需要分析被适应性采样拒绝的测序片段。
| 仅对目标序列进行碱基识别 | 测序期间进行碱基识别的片段 | 可同时运行的测序芯片数量 |
|---|---|---|
| 关闭 | 所有测序片段,包括适应性采样拒绝的短片段。这些短片段可作为目标区域数据的补充,提供低深度全基因组及甲基化信息。 | 较少,因为所有片段均需进行碱基识别。 |
| 开启 | 仅限目标片段。被拒绝的片段以原始信号形式保存至运行(run)文件夹下的 pod5skip 文件夹,如有需要,可在测序结束后进行碱基识别。 | 可使用设备的全部芯片位置。 |
有关各设备开启或关闭“仅对目标序列进行碱基识别”选项后,可同时支持多少张芯片进行实时碱基识别,请参阅《适应性采样技术指南》中的 设备限制 一节。若同时运行的芯片数量超过指南中列出的上限,碱基识别将无法跟上测序进度,可能降低富集效果。
如需同时运行更多测序芯片并保留非目标数据,可 开启 “仅对目标序列进行碱基识别”,在测序结束后再对被拒绝的片段进行碱基识别,但这会延长设备的使用时间。具体操作请参阅下文“数据输出与分析”中的“测序结束后对被拒绝的片段进行碱基识别”一节。
当关闭 POD5 输出选项时,系统将不保留已完成碱基识别的测序片段的原始信号。
如需在测序结束后对适应性采样拒绝的序列片段进行碱基识别,请 开启 POD5 输出选项。当启用“仅对目标序列进行碱基识别”时,系统会跳过对此类序列片段的碱基识别,并将其原始信号保存至 pod5skip 文件夹。
PromethION 平台适应性采样的 MinKNOW 参数设置
在 MinKNOW 中设置测序实验:
在 MinKNOW 中,选择 开始测序(Start sequencing),然后输入芯片位置、实验名称和样本 ID。
此处填写的样本 ID 由整张测序芯片共用。输出文件和文件夹以条形码编号(如barcode01、barcode02和barcode03)区分三个样本。请记录每个样本对应的条形码编号。
如需为每个样本单独命名,请通过样本列表启动测序,具体操作请见下文 “可选:通过样本列表启动测序实验”。请按下表配置测序参数,其余设置保持默认值。
界面 设置项 设置 试剂盒 选择试剂盒 免扩增条形码试剂盒-24 V14(SQK-NBD114.24)或
免扩增条形码试剂盒-96 V14(SQK-NBD114.96)实验运行配置 修饰碱基识别 开启,并选择 CpG 位点的 5mC 和 5hmC 序列比对 开启,并上传与基因集匹配的参考 FASTA 文件:遗传性癌症基因集使用 GIAB v3;对于自定义基因集,请上传设计该基因集时所用参考基因组版本的 FASTA 文件(参见第 4 节“参考基因组”) 适应性采样 开启,并选择富集(Enrich)。上传富集用 BED 文件( *_enrichment.bed)以及与序列比对设置中相同的 FASTA 参考文件。仅对目标序列进行碱基识别 按上文说明开启或关闭。 输出 FASTQ 关闭 POD5 默认关闭。如需在测序结束后对适应性采样中被拒绝的测序片段进行碱基识别,请开启。 启动实验。
可选:选择“通过样本列表启动测序实验”
使用样本表启动测序时,您可为三个样本分别指定名称。MinKNOW 会按样本名称而非条形码编号命名输出文件和文件夹。测序参数仍按上表设置。
创建一个 CSV 文件,每个条形码对应一行。文件须包含以下列:
- experiment_id (实验名称,所有行均填写同一名称)
- kit(SQK-NBD114.24)
- barcode(例如,barcode01)
- alias (条形码对应的样本名称)
名称长度为 1–40 个字符,仅可包含字母、数字、连字符(-)、下划线(_)和英文句点(.),不得包含空格。 - position_id (设备上的测序位置编号),或
- flow_cell_id (测序芯片 ID)
保存文件时,请确保文件名以 .csv 结尾,否则 MinKNOW 无法识别该文件。
在 MinKNOW 中,选择“通过样本列表启动测序实验”(Start from a sample sheet),而 非 “开始测序”(Start sequencing),并选择已保存的 CSV 文件。MinKNOW 会从文件中自动读取测序芯片位置、实验名称和样本名称。其余测序参数请按上表设置。
有关样本列表的其他选项,请参阅 MinKNOW 文档中的 sample sheet section(样本列表选择)一节。
我们不建议在同一设备上同时进行测序和数据分析。
为确保设备计算性能满足测序及碱基识别需求,我们强烈建议您避免同时运行这两项任务。请确保测序实验完成后再启动数据分析;若设备正在进行数据分析,请避免启动新的测序任务。
13. 数据输出及分析
数据输出
测序结束后,三个样本的数据将分别保存于对应的条形码文件夹中。每个 BAM 文件均包含经碱基识别的测序片段及其比对结果。比对所用的参考序列来自您上传至 MinKNOW 的 FASTA 文件。CpG 位点的 5mC 和 5hmC 识别结果仅在测序配置中启用修饰碱基识别时才会写入测序片段记录。
关闭 仅对目标序列进行碱基识别 选项时,BAM 文件也包含适应性采样中被拒绝的短测序片段。启用该选项后,系统不会对这些片段进行碱基识别,而是将其原始信号数据保存至 pod5skip 文件夹。
| 输出文件 | 说明 |
|---|---|
| 比对后的 BAM 文件(每个条形码对应一个文件夹) | 包含各样本经碱基识别和比对的测序片段。若启用修饰碱基识别,还会包含相应的识别结果。 |
| 测序摘要与实验运行报告 | 汇总本次测序的读长、数据产出和适应性采样决策等信息。 |
Basecalling rejected reads after the run
If Basecall on-target reads only was switched On, the reads rejected by Adaptive Sampling are written to the pod5skip folder in the run folder. They can only be basecalled if POD5 output was switched On when the run was set up. Wait until the sequencing run has finished before basecalling them, as both processes compete for the compute on the device. Use the same basecalling model, modified base setting, reference FASTA file and barcode kit as the run, so that the rejected reads can be analysed alongside the BAM files from the run.
In the EPI2ME Desktop App, use the wf-basecalling workflow with the pod5skip folder as input, the HAC model and 5mC and 5hmC modified base model used for the run, the reference FASTA file, barcode kit SQK-NBD114.24 (or SQK-NBD114.96) and BAM output. The workflow writes aligned BAM files for each barcode.
On the command line, use the standalone Dorado software in two steps.
First basecall, align and identify the barcodes, replacing the file names with your own:
dorado basecaller hac,5mCG_5hmCG pod5skip/ --recursive --reference reference.fasta --kit-name SQK-NBD114.24 > rejected.bam
Then split the reads by barcode, keeping the alignment:
dorado demux --output-dir rejected_by_barcode --no-classify --no-trim --sort-bam rejected.bam
The --no-trim option is needed because dorado demux removes the alignment when it trims barcodes; the barcodes have already been trimmed during basecalling.
The --sort-bam option sorts and indexes the files for each barcode, and --recursive reads any sub-folders of the pod5skip folder.
The hac model name selects the current HAC model, which may be newer than the model used during the run; for an exact match, use the full model name shown in the run report.
分析
请使用 *_analysis.bed 计算目标区域的测序深度,并仅在该文件列出的区域内检测变异。使用 *_enrichment.bed 计算测序深度会将缓冲区一并纳入统计,无法单独反映目标区域的测序深度。如需按外显子报告测序深度,请使用 *_exons.bed。
如您使用自定义生殖系基因集,可在 EPI2ME Desktop 中或通过命令行运行 wf-human-variation 工作流程,对每个样本分别进行变异检测、单倍型定相和甲基化分析。分析时需提供该样本条形码对应的 BAM 文件、参考序列 FASTA 文件和 *_analysis.bed 文件。
对于遗传性癌症基因集(Hereditary Cancer Panel),请使用 wf-hereditary-cancer 工作流程。
14. 测序芯片的重复利用及回收
采用本方法完成实验后,不建议清洗并重复使用测序芯片。
由于本实验测序时间较长,因此不建议在实验完成后重复使用该测序芯片,以免数据产出不足,无法满足后续分析需求。
请返还测序芯片,以便 Oxford Nanopore 妥善回收其中的有限资源。
请将测序芯片装回原包装的吸塑盒中,以避免运输途中受损。
您可在 此处找到回收测序芯片的说明。
如您在测序实验过程中遇到问题或存在疑问,请参阅下文的“疑难解答指南”。
15. DNA提取和文库制备过程中可能出现的问题
以下表格列出了提取和文库制备过程中的常见问题,以及可能的原因和解决方法。
我们还在 Nanopore 社区的Support板块提供了常见问题解答(FAQ)。
如果以下方案仍无法解决您的问题,请通过电邮(support@nanoporetech.com)或 纳米孔社区的在线支持(LiveChat)联系我们。
低质量样本
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| 低纯度DNA(Nanodrop测定的DNA吸光度比值260/280<1.8, 260/230 <2.0-2.2)。 | 用户所使用的 DNA 提取方法未能达到所需纯度。 | 您可在污染物专题技术文档中查看污染物对测序实验的影响。请尝试其它不会导致污染物残留的提取方法 。 请考虑将样本再次用磁珠纯化。 |
经 AMPure 磁珠纯化后的 DNA 回收率低
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| 低回收率 | AMPure磁珠量与样本量的比例低于预期,导致DNA因未被捕获而丢失。 | 1.AMPure 磁珠沉降速度较快,因此在将磁珠加入样品前,请务必充分重悬混匀。 2.当AMPure磁珠量与样品量的比值低于0.4:1时,所有的DNA片段都会在纯化过程中丢失。 |
| 低回收率 | DNA 片段短于预期。 | AMPure磁珠量与样本量的比值越低,针对短片段的筛选就越严格。每次实验时,请先使用琼脂糖凝胶(或其他凝胶电泳方法)确定起始DNA的长度,据此计算出合适的AMPure磁珠用量。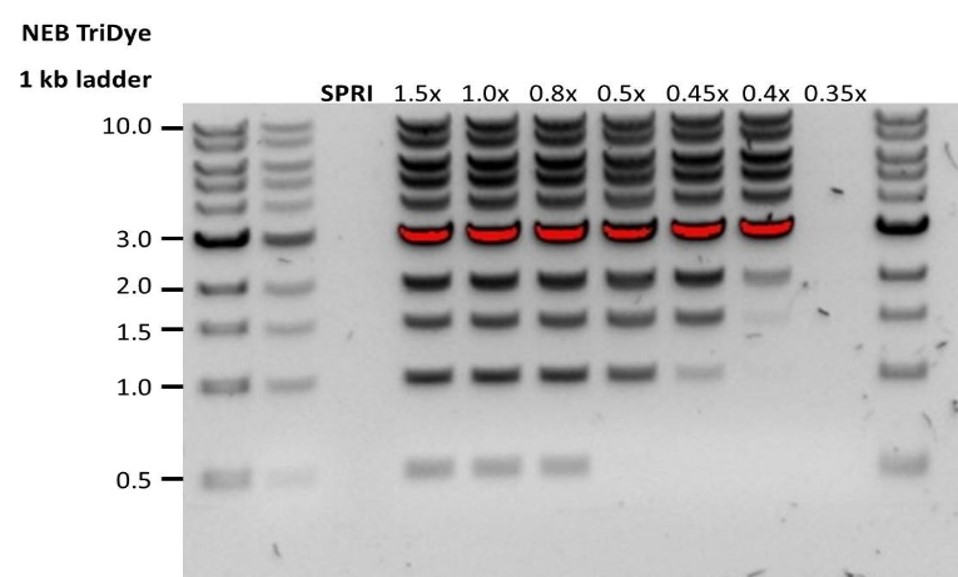 |
| 末端修复后的 DNA 回收率低 | 清洗步骤所用乙醇的浓度低于70% 。 | 当乙醇浓度低于70%时,DNA会从磁珠上洗脱下来。请确保使用正确浓度的乙醇。 |
16. 测序过程中可能出现的问题
以下表格列出了提取和文库制备过程中的常见问题,以及可能的原因和解决方法。
我们还在 Nanopore 社区的Support板块提供了常见问题解答(FAQ)。
如果以下方案仍无法解决您的问题,请通过电邮(support@nanoporetech.com)或 纳米孔社区的在线支持(LiveChat)联系我们。
MinKNOW Mux 扫描在测序起始时报告的活性孔数少于芯片质检时报告的活性孔数
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| MinKNOW Mux 扫描在测序起始时报告的活性孔数少于芯片质检时报告的活性孔数 | 纳米孔阵列中引入了气泡。 | 在对通过质检的芯片进行预处理之前,请务必排出预处理孔附近的气泡。否则,气泡会进入纳米孔阵列对其造成不可逆转地损害。如何为 PromethION 测序芯片上样视频中演示了避免引入气泡的最佳操作方法。 |
| MinKNOW Mux 扫描在测序起始时报告的活性孔数少于芯片质检时报告的活性孔数 | 测序芯片未正确插入测序仪。 | 停止运行测序,将芯片从测序仪中取出,再重新插入测序仪内。请确保测序芯片被牢固地嵌入测序仪中,且达到目标温度。您也可尝试将芯片插入仪器的其它芯片槽进行测序(如适用)。 |
| MinKNOW Mux 扫描在测序起始时报告的活性孔数少于芯片质检时报告的活性孔数 | 文库中残留的污染物对纳米孔造成损害或堵塞。 | 在测序芯片质检阶段,我们用芯片储存缓冲液中的质控DNA分子来评估活性纳米孔的数量。而在测序开始时,我们使用DNA文库本身来评估活性纳米孔的数量。因此,活性纳米孔的数量在这两次评估中会有约10%的浮动。如测序开始时报告的孔数明显降低,则可能是由于文库中的污染物对膜结构造成了损坏或将纳米孔堵塞。用户可能需要使用其它的 DNA 提取或纯化方法,以提高起始核酸的纯度。您可在 污染物专题技术文档中查看污染物对测序实验的影响。请尝试其它不会导致污染物残留的 提取方法。 |
MinKNOW脚本失败
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| MinKNOW 显示 "Script failed”(脚本失败)。 | 重启计算机及 MinKNOW。如问题仍未得到解决,请收集 MinKNOW日志文件并联系我们的技术支持。如您没有其他可用的测序设备,我们建议您先将装有文库的测序芯片置于4°C 储存,并联系我们的技术支持团队获取进一步储存上的建议。 |
纳米孔利用率低于40%
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| 纳米孔利用率<40% | 测序芯片中的文库量不够。 | 请确保您按照相应实验指南,向测序芯片中加入正确浓度和体积的测序文库。请在上样前对文库进行定量。 |
| 纳米孔利用率接近0 | 在接头连接后的纯化步骤中并未使用 LFB 或 SFB 洗涤,而是使用了酒精。 | 酒精可导致测序接头上的马达蛋白变性。请确保在测序接头连接后使用洗涤缓冲液(LFB或SFB)。 |
| 纳米孔利用率接近0 | 测序芯片中无系绳。 | 测序系绳(FCT)是随着预处理液加至芯片的。请确保在制备预处理液时,将测序芯片系绳(FCT)加入测序芯片冲洗液(FCF)中。 |
读长短于预期
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| 读长短于预期 | DNA样本降解 | 读长反映了起始DNA片段的长度。起始DNA在提取和文库制备过程中均有可能被打断。 1.请查阅纳米孔社区中的 提取方法 以获得最佳DNA提取方案. 2.在进行文库制备之前,请先跑电泳,查看起始DNA片段的长度分布。 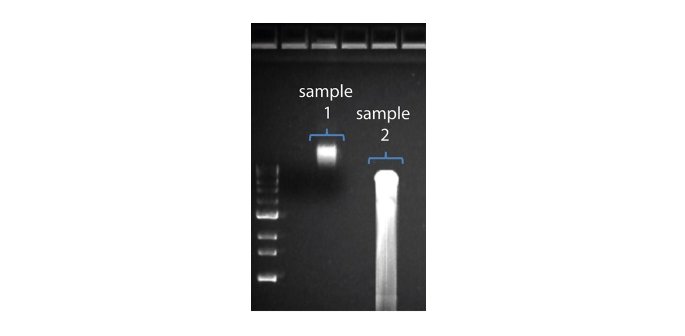 在上图中,样本 1 为高分子量 DNA,而样本 2 为降解样本。 3.在制备文库的过程中,请避免使用吹打或/和涡旋振荡的方式来混合试剂。轻弹或上下颠倒离心管即可。 |
大量纳米孔处于不可用状态
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
大量纳米孔处于失活状态(在通道面板和纳米孔活动状态图上以蓝色表示。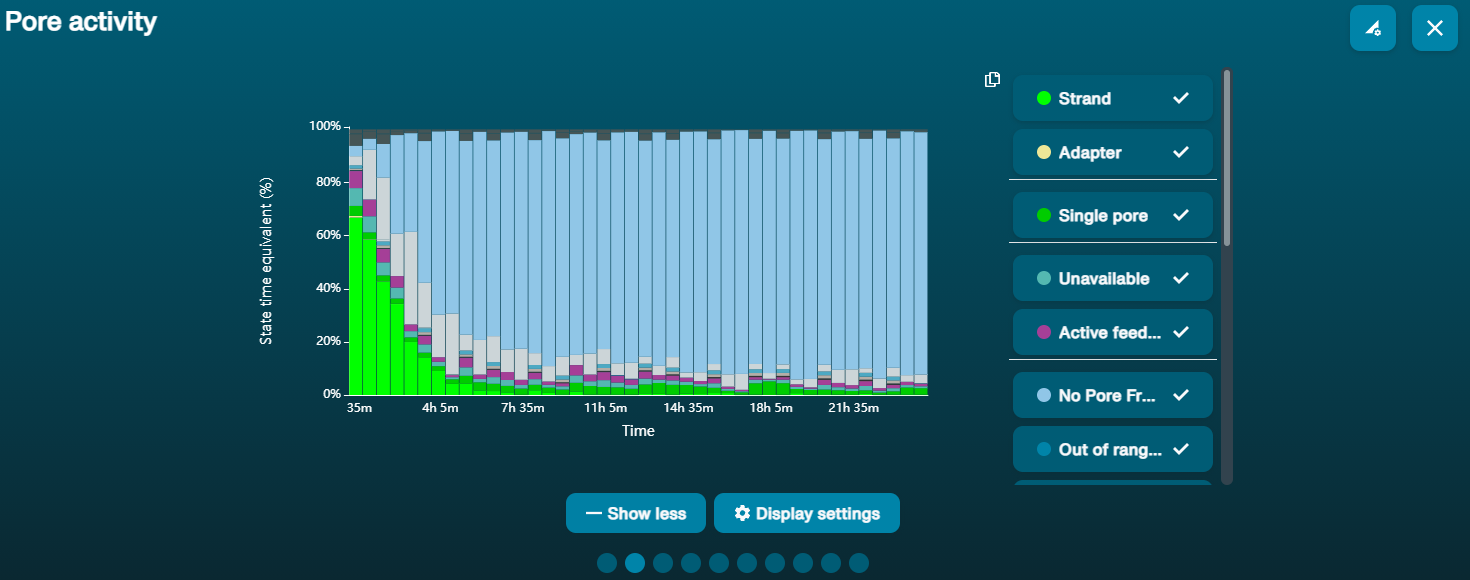 上方的纳米孔活动状态图显示:状态为不可用的纳米孔的比例随着测序进程而不断增加。 | 样本中含有污染物。 | 使用MinKNOW中的“Unblocking”(疏通)功能,可对一些污染物进行清除。如疏通成功,纳米孔的状态会变为"测序孔"(sequencing pore)。若疏通后,状态为不可用的纳米孔的比例仍然很高甚至增加: 用户可使用 测序芯片冲洗试剂盒 (EXP-WSH004)进行核酸酶冲洗 操作。 |
大量纳米孔处于“失活”(Inactive)状态
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| 大量纳米孔处于失活状态(在通道面板和纳米孔活动状态图上以浅蓝色表示。膜结构或纳米孔遭受不可逆转地损伤)。 | 测序芯片中引入了气泡。 | 在芯片预处理和文库上样过程中引入的气泡会对纳米孔带来不可逆转地损害。请观看如何为 PromethION 测序芯片上样了解最佳操作方法。 |
| 大量纳米孔处于失活/不可用状态 | 存在与DNA共纯化的化合物 | 已知的化合物包括多糖等。 使用 QIAGEN PowerClean Pro 试剂盒进行纯化。 |
| 大量纳米孔处于失活/不可用状态 | 样本中含有污染物。 | 您可在污染物专题技术文档中查看污染物对测序实验的影响。请尝试其它不会导致污染物残留的提取方法。 |
温度波动
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| 温度波动 | 测序芯片和仪器接触不良 | 检查芯片背面的金属板是否有热垫覆盖。重新插入测序芯片,用力向下按压,以确保芯片的连接器引脚与测序仪牢固接触。如问题仍未得到解决,请联系我们的技术支持。 |
未能达到目标温度
| 现象 | 可能原因 | 措施及备注 |
|---|---|---|
| MinKNOW显示“未能达到目标温度” | 测序仪所处环境低于标准室温,或通风不良(以致芯片过热)。 | MinKNOW 会限定测序芯片达到目标温度的时间。当超过限定时间后,系统会显示出错信息,但测序实验仍会继续。值得注意的是,在错误温度下测序可能会导致通量和数据质量(Q值)的降低。请调整测序仪的摆放位置,确保将其置于室温下、通风良好的环境中,再在MinKNOW中重启进程。 |
Last updated: 11/11/2026
文档选项